Weight-Space Programming: Astra правит веса
Содержание
Weight-Space Programming, или программирование весов нейросети, это подход, где языковая модель сама читает и правит веса другой нейросети. Задачу ей ставят словами, обучение при этом не запускают. 2 ноября подход показали на GPT-6 Astra. Она посмотрела на веса маленькой Qwen, нашла, почему та зацикливается, и поправила 0.016% чисел. На математическом тесте MATH-500 доля решённых задач выросла с 7.9% до 48.1%.
Я привык вайбкодить приложения: описал словами, агент написал код. Здесь словами описывают поведение самой нейросети. Опыты пока ранние и на маленьких сетях. Но похоже, следующим слоем вайбкодинга становятся сами модели.
Что такое веса нейросети
Нейросеть внутри устроена как огромный набор чисел. Каждое такое число называют весом. Вопрос, который вы задали модели, превращается в числа и проходит через веса слой за слоем: их умножают, складывают, передают дальше. На выходе получается ответ. Всё, что модель умеет, записано в весах. Код вокруг них только гоняет числа.
У Qwen3.5-0.8B весов 800 миллионов. У крупных моделей их в тысячи раз больше: у открытой Kimi K3 2.8 триллиона, у DeepSeek V4-Pro 1.6 триллиона. Сколько весов у Opus от Anthropic и у самой GPT-6 Astra, их создатели не раскрывают. Руками их никто не пишет. Их подбирает обучение: модель прогоняют на миллионах примеров, и после каждой ошибки программа-оптимизатор чуть сдвигает каждое число в сторону правильного ответа. Этот способ называют градиентным спуском. За что отвечает конкретное число, человек при этом не знает. Открыть веса и прочитать их, как код, обычно не получается.
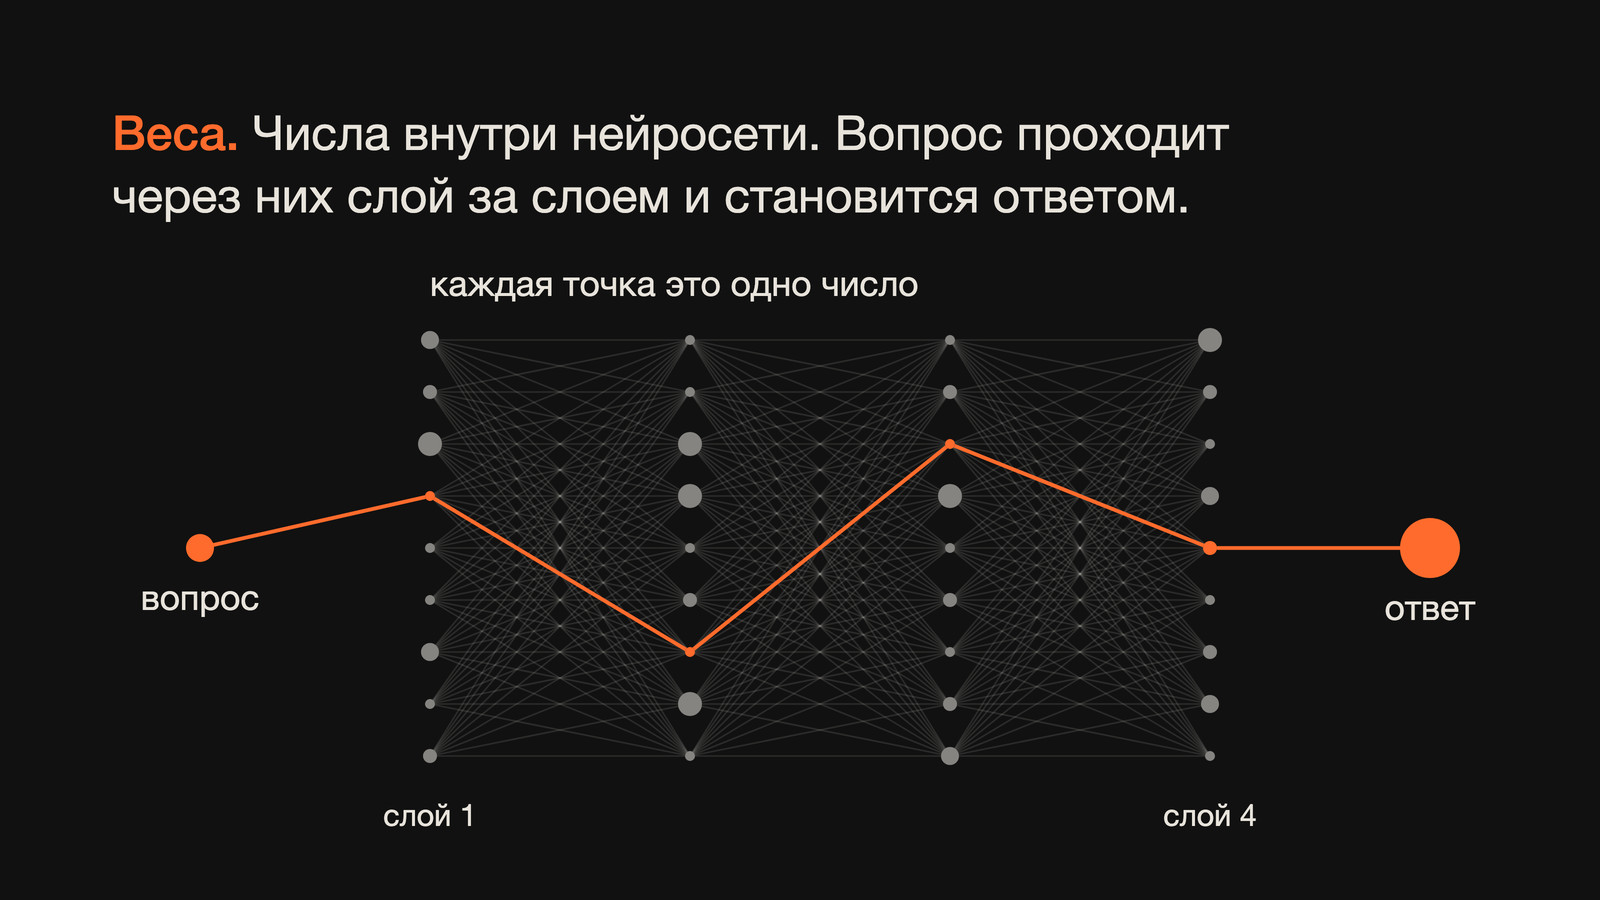
Поэтому работа и удивляет: GPT-6 Astra открыла эти числа, поняла, что они делают, и сама поправила нужные.
Как GPT-6 Astra читает и пишет веса нейросети
Работа называется Sparks of Weight-Space Programming, её авторы Rikiya Takehi, Jayden Teoh, Alex Zhang и Omar Khattab, создатель DSPy из MIT. Они проверяли простой вопрос: может ли языковая модель работать с весами другой нейросети так же, как агент работает с кодом. То есть открыть их, понять, что они делают, и поправить.
Начали с маленьких сетей, которые играют в простые видеоигры вроде Breakout, где ракетка внизу экрана отбивает мяч. Такая сеть смотрит на экран и выбирает ход, а весов у неё немного, они помещаются в один запрос к модели. Только после этого авторы перешли к языковой модели Qwen.
Правило во всех опытах одно: запускать обучение GPT-6 Astra запретили. Писать код, который сам подбирает числа на примерах, было нельзя. Модель должна была рассуждать, что считает каждая часть сети, и менять числа сама.
Сначала Astra читала. Ей дали четыре сети одинаковой формы, обученные играть в четыре разные игры, и спросили: на какой игре учили эту сеть? Список игр не показали. Astra угадала все четыре. Например, у сети для Breakout веса первого слоя собраны вдоль нижнего ряда экрана, там, где ходит ракетка.
Потом писала. Для трёх игр MinAtar Astra с первой попытки собрала сети с нуля, без обучения и без запуска. Соперниками были сети, которые учили обычным способом: алгоритмом PPO, где сеть играет миллионы ходов и понемногу подправляется по результату. Сети PPO после 100 миллионов шагов она обошла во всех трёх играх. С сетями PPO после 500 миллионов шагов вышло так: в Breakout её сеть набрала 517 очков против 25, в Asterix почти догнала соперника, в Seaquest набрала около 60% его очков. По словам авторов, Astra сначала придумывает программу, а потом переводит её в веса: первый слой считает, куда упадёт мяч, второй двигает туда ракетку.
Дальше го. В сети для го 1.5 миллиона параметров, то есть весов. Столько чисел не влезает в контекст, объём текста, который модель видит за раз. Поэтому Astra дали песочницу: отдельное окружение, где она сама запускает код на Python. Веса в начале были нулями, и она записала в них правила игры: свои камни, свободные точки рядом, группы под угрозой, оценку каждого хода. Вышел один скрипт на 336 строк. Без единого пробного прогона её сеть выиграла больше половины партий у двух сетей PPO поменьше. Прогон здесь значит запустить сеть и посмотреть на результат. Когда ей разрешили 50 пробных прогонов, её сеть обыграла сеть PPO того же размера, обученную на 20 миллионах партий.
Как Astra починила зацикливание Qwen
Самый близкий к жизни опыт был с языковой моделью Qwen3.5-0.8B. У маленьких рассуждающих моделей есть известная болезнь: они зацикливаются и повторяют одно и то же, пока ответ не упрётся в лимит длины (его считают в токенах, кусочках слов). Об этом предупреждает даже карточка модели Qwen.
Задача для Astra звучала примерно так (пересказ постановки из статьи):
Astra нашла причину петель в весах и поправила 131 072 числа из 800 миллионов. Когда ей разрешили 50 прогонов, результат на MATH-500 вырос с 7.9% до 48.1%, на втором математическом тесте GSM8K с 13.8% до 67.1%. Доля ответов, упёршихся в лимит токенов, упала с 93% до 33%. При 10 и 25 прогонах петли почти не уходили, и рост был скромный: MATH-500 от 12 до 14%.
Интереснее всего, что правка помогла и за пределами математики. Петли мешали модели везде. На тесте IFEval, который проверяет, выполняет ли модель инструкции, результат вырос с 21% до 62%. Модель стала дописывать ответы, которые и раньше умела найти.
Чем это проще дообучения
Раньше, чтобы поменять поведение модели, её дообучали. Это называют файн-тюнингом: собирают набор примеров, арендуют видеокарты и часами прогоняют модель через обучение, пока оптимизатор сдвигает веса. Нужны данные, железо и человек, который умеет всё это настроить. Для одного исправления выходит дорого.
В опыте с Qwen ничего этого не было. Обучение не запускали, градиенты не считали. Веса Astra разбирала в Python на обычном процессоре, а саму модель запустила на задачах всего 50 раз. Главная работа шла в рассуждениях Astra, то есть в токенах языковой модели. Сколько стоила правка в деньгах, авторы не пишут.
Для меня здесь главный сдвиг. Похоже, точечную правку модели скоро можно будет заказать агенту по подписке, как сейчас заказывают ему код. Своя ферма видеокарт и команда для дообучения для этого не понадобятся.
Где программирование весов пока не работает
Авторы показали и два провала.
С Gemma 3 270M не вышло ничего. Эта модель зацикливается редко: в лимит упираются 8.5% ответов против 93% у Qwen. Ошибки у неё обычные: арифметика и алгебра. Astra не нашла одного узла, который можно выключить. Её правки сдвинули MATH-500 максимум на пункт, и сама Astra написала, что улучшение не доказано. Авторы делают вывод: правка весов может убрать помеху, за которой спряталось умение. Добавить умение, которого у модели нет, она не может.
Второй провал про поиск скрытого поведения. Авторы обучили две одинаковые Gemma, одну из них сделали льстивой. По одним весам Astra льстеца не нашла ни в одной из четырёх попыток. Нашла, когда ей показали внимание модели: на какие слова модель опирается, пока читает текст. Тексты для проверки Astra написала сама. Тогда она указала на льстеца во всех трёх парах.
Все сети в опытах маленькие. В крупнейшей 800 миллионов параметров, самые сильные модели на рынке на порядки больше. Авторы пишут прямо: мешают длина контекста и неудобные харнессы. Харнесс это программа вокруг модели, через которую она получает веса и запускает код.
Почему это следующий слой вайбкодинга
Weight-Space Programming продолжает идею, которой почти десять лет. В 2017 году Андрей Карпатый написал эссе Software 2.0: нейросети станут новым кодом, а веса новым исходником. Авторы ссылаются на него. Тогда писать такой исходник умел только оптимизатор.
Вот как сдвигался слой, с которым работает вайбкодер. Сначала мы просили агента написать код, и так появился софт для одного человека. Потом агенты стали писать и править промпты для других агентов. Теперь модель правит числа внутри другой модели по задаче, сформулированной словами. Каждый раз мы описываем, что хотим получить, и всё меньше думаем, как это устроено внутри.
Я и сам проверяю код агента по одному признаку: работает или нет. В опыте с Qwen то же самое: никто не разбирал руками 131 тысячу чисел. Задали цель, дали автоматическую проверку прогонами и посмотрели на цифры.
Можно ли попробовать программирование весов самому
Да, условия опыта несложно повторить. Готового инструмента авторы пока не выпустили, но в статье описано, в чём работала Astra: в Python-сессии, похожей на блокнот, где уже загружены веса модели. Внутри есть numpy и PyTorch на обычном процессоре. Обучать модель и смотреть градиенты нельзя, а запусков модели на задачах дают ограниченное число: 10, 25 или 50.
Такие же условия можно поставить своему агенту. Я бы написал примерно так:
Повторится ли результат с другой моделью, неизвестно: в статье веса правила только Astra. Авторы выложили полные логи всех опытов: там задания для Astra, её ответы и ход рассуждений, код, который она запускала, и сами сети. По логам видно, с чего она начинала и как проверяла каждую правку.
Следующий шаг авторы уже объявили: бенчмарк, то есть общий тест для сравнения моделей, и харнесс для программирования весов. Когда они выйдут, станет понятно, умеют ли это другие модели и сколько стоит такая правка.
Частые вопросы
Что такое веса нейросети?
Веса это числа внутри нейросети, через которые проходит вопрос по пути к ответу. Всё, что модель умеет, записано в них. Обычно их подбирает обучение на миллионах примеров, и человек не знает, за что отвечает конкретное число.
Что такое Weight-Space Programming?
Weight-Space Programming, или программирование весов нейросети, это подход, где языковая модель сама читает и пишет веса другой нейросети. Задачу ей ставят словами, обучение при этом не запускают.
Кто придумал Weight-Space Programming?
Термин ввели Rikiya Takehi, Jayden Teoh, Alex Zhang и Omar Khattab, создатель DSPy из MIT, в работе Sparks of Weight-Space Programming от 2 ноября 2026 года.
Как GPT-6 Astra правит веса нейросети?
Astra рассуждает, что считает каждая часть сети, и меняет числа сама. Писать цикл обучения ей запрещали. В опыте с Qwen3.5-0.8B она правила веса в песочнице на Python и проверяла результат ограниченным числом прогонов.
Это замена обучению моделей?
Пока нет. Опыты шли на сетях до 800 миллионов параметров. В опыте с Gemma правка не добавила умения, которого у модели не было.
Какая модель это умеет?
В работе проверяли GPT-6 Astra от OpenAI. Другие модели авторы обещают сравнить в будущем бенчмарке.
Можно ли попробовать программирование весов самому?
Да. Дайте агенту Python с PyTorch, загруженные веса небольшой модели и ограниченное число запусков, а обучать запретите: в таких условиях работала Astra. Готового инструмента авторы пока не выпустили, но выложили логи всех опытов.