S1 Есть вопрос, нужно ли заводить её на каждую мелочь?
S1 Совершенно нет.
S1 Нам нужно заводить её там, где нам важно проверить сам результат.
S1 Например, это может быть пост, это может быть какое-то важное дело.
…
S1 Как раньше во всех этих трекерах возвращалась задача проверяющему.
S1 Можно какой-то дополнительный уровень настроить, что проверяют агенты, но всё равно проверяет её человек.
S1 Поэтому какие-то разные мелкие вещи, типа починить текст, что-то ещё, на этом уровне можно не заводить задачи.
S1 И вообще в целом старайтесь не придумывать лишние вещи.
…
S1 Главное агенту записать правило, что оно и как оно работает, что у тебя есть файл TODO.md, что у тебя есть файл PROGRESS.md
Когда заводить задачу
Заводить задачу на каждую мелочь не нужно. Критерий: важность проверки результата. Пост, важное дело, вайбкодинг, который в конце ждёт проверка человека: на это заводим. Логика как в классических трекерах: исполнитель отметил готово, задача вернулась проверяющему, и проверяющий здесь вы. Дополнительный уровень, где проверяют агенты, настроить можно, но финальная проверка остаётся за человеком. Правку текста и прочую мелочь можно вести без задач. Старайтесь не придумывать лишние вещи. … Главное записать агенту правило: есть TODO.md, есть PROGRESS.md, задачи лежат в этой папке.
После каждой встречи потока Personal Corp запись сама становится страницей урока. Расшифровку делает ElevenLabs Scribe. Конспект, главы видео и описание для YouTube пишет модель по одному промпту. Модель-критик сверяет конспект с расшифровкой и присылает исправления. Остальное делает обычная программа на моём сервере: проверяет текст, загружает видео, выкладывает страницу. Я решил главное: перед публикацией конспект не читает никто. Поэтому промпты написаны так, чтобы ошибку поймали программа и критик.
Этот гайд для тех, кто ведёт уроки, вебинары или рабочие созвоны и хочет отдавать запись модели. Гайд появился после вопроса в группе потока: как устроены эти конспекты и как сделать так же. Здесь оба промпта целиком и объяснение, зачем в них каждая часть. Есть и третий, короткий: он исправляет строки с ошибками. Кода почти нет. Как выбрать модель, я разобрал в гайде про эвалы: так называют проверку модели на своей задаче. Как расшифровать запись, рассказано в гайде про расшифровку. Вы унесёте два промпта, которые можно взять себе, и пять правил для любого пересказа: протокола созвона, сводки чата, выжимки из договора.
Несколько слов, которые встретятся дальше:
- Расшифровка
- Текст записи, где у каждой реплики есть время и метка голоса: S0, S1. Метки ставит распознавание, имён оно не знает.
- Промпт
- Текст задания, который модель получает целиком за один раз. Здесь в нём правила, шаблон ответа, расшифровка и чат встречи.
- Главы
- Оглавление видео со временем. По нему ученик находит в записи нужное место.
- Критик
- Отдельный вызов модели со своим промптом. Критик читает конспект рядом с расшифровкой и на каждую ошибку присылает замену.
- Пайплайн
- Шаги от записи до страницы урока. Часть делает модель, часть обычная программа.
Что получает ученик
Ученик открывает урок на платформе и идёт по шагам: цели, запись, конспект, материалы, домашка, проверка себя. Запись разбита на главы, и у глав есть ссылки на свои разделы конспекта. В конце несколько вопросов с ответами из того же конспекта.
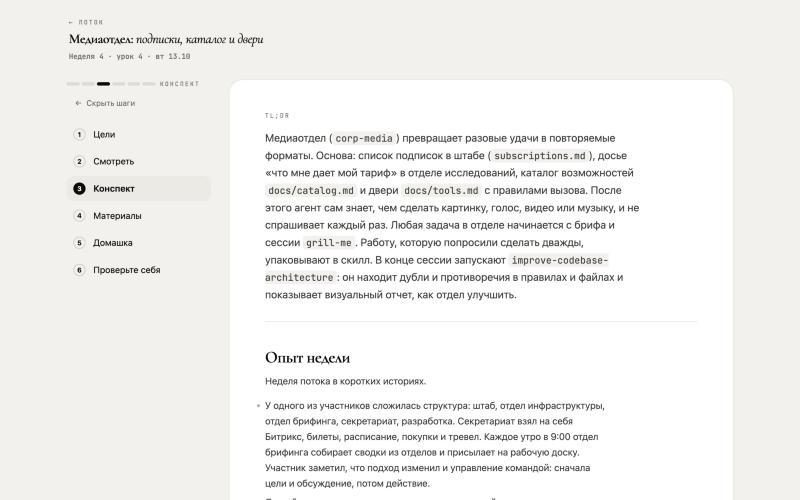
До октября страницу собирал агент в сессии на моём компьютере. Каждая встреча ждала человека от четырёх до двадцати одного часа. Теперь всё делает сервер сам. Ученики видят страницу, только когда прошла последняя проверка. Наутро в 8:00 по Москве в группе потока выходит пост со ссылкой на запись.
Главное на странице конспект. Его читают те, кто пропустил встречу, и делают по нему. Поэтому ошибка в конспекте дорогая: ученик примет её за совет.
Как запись становится конспектом
Модель здесь пишет конспект, правит строки с ошибками и проверяет текст в роли критика. Всё, для чего не нужно понимать смысл, делает программа: проверяет названия и форму текста, ставит время глав, вставляет исправления.
Модель здесь работает без инструментов: она не открывает файлы и ничего не пишет на диск. Программа сама складывает в один промпт всё нужное: правила, расшифровку, чат и список правильных названий. Модель отвечает обычным текстом, программа раскладывает его по файлам.
До 2 октября этот шаг делал агент, то есть модель с доступом к файлам. Он сам ходил по файлам и перечитывал их на каждом шаге. На одну встречу уходили миллионы токенов, сейчас десятки и сотни тысяч. Токены это кусочки текста, по ним подписка считает лимит. Как я пришёл к одному промпту и что показал замер девяти моделей, разобрано в гайде про эвалы.
Что написано в промпте конспекта
Ниже промпт без сокращений, блок раскрывается кнопкой «Показать целиком». В двойных фигурных скобках пропуски: перед отправкой программа подставляет туда данные встречи.
Напиши конспект {{WHAT}} потока Personal Corp 3 ({{DATE_HUMAN}}, запись {{DURATION_MIN}} минут) по автоматической расшифровке ниже.
{{TOPIC_NOTE}}

Конспект уходит ученикам без проверки человеком. Его читают те, кто пропустил встречу, и по главам ищут место в записи. Поэтому в нём только то, что есть в расшифровке: ученик примет любую фразу конспекта за совет программы и сделает по ней.

Кто говорит. Метки S0, S1… поставило распознавание. {{SPEAKERS}} Остальные голоса — участники потока: они рассказывают про свои проекты и задают вопросы. Что рассказал участник, пиши как его опыт («у одного из участников потока…»): советом программы это становится, только если Серёжа сам это советует. Участника по тексту не узнать: нет имён и ников, страны, города, банка и карты, работодателя, семьи, здоровья, денег. Серёжу можно называть по имени.

Как писать. Текст для самостоятельного чтения: приём, зачем он и как его сделать («ручное сжатие сессии перед новой задачей экономит лимиты»). Кто что показал на встрече и в каком порядке, ученику не нужно; про саму расшифровку и про то, что на встрече не решили, тоже не пиши. Сохраняй степень уверенности сказанного: «обычно», «можно», «Серёжа предполагает» не превращаются в «всегда», «нужно», «только». Без таймкодов в тексте и без слов «ведущий», «прозвучал». Короткие предложения. Названия скиллов, файлов и команд в обратных кавычках: `manager`, `CLAUDE.md`. Названия инструментов пиши как в списке терминов. Инструмент, скилл или сервис, которого в списке нет, назови: если распознавание явно исказило название известного продукта и ты знаешь, как оно пишется, пиши правильно, иначе как в расшифровке или чате. Ссылки бери только из чата. Конспект проверяет замок текста, он не пропустит:
- длинное тире «—» (вместо него двоеточие, точка или запятая);
- обороты «не X, а Y», «X, а не Y», «не просто»;
- жирный шрифт `**…**`;
- эти слова, пиши справа: {{WORDS_MAP}}

Объём около {{WORDS}} слов. Разделы идут в порядке встречи, заголовок раздела называет суть.

Ответ: ровно три блока ниже, без вступления и пояснений.

===LESSON===
# {{LABEL}} · <тема встречи, 3–6 слов>

> <одна фраза: что ученик вынесет из встречи>

## TL;DR

<два коротких абзаца с главным>

## Цели урока

- <3–5 пунктов: что ученик сможет сделать>

## <смысловой раздел>

<текст; 6–12 таких разделов>

## ДЗ

- <только если на встрече дали или уточнили домашку; иначе этого раздела нет>

## Проверь себя

- Q: <вопрос по конспекту>
  A: <ответ, который есть в конспекте выше>

<3–5 пар Q/A>

===CHAPTERS===
{{CHAPTER_FORMAT}}

===META===
Описание: <2–3 предложения для YouTube: что разбирают на встрече>
Открыто: <что осталось нерешённым или обещано на следующие встречи, одной строкой; или «нет»>
Темы поста: <{{POST_TOPICS}}>

Термины (как писать названия): {{TERMS}}

Чат встречи: {{CHAT}}

Расшифровка, строка = [время метка] реплика:

{{TRANSCRIPT}}
Второй абзац называет цену ошибки. Конспект уходит ученикам без проверки человеком, его читают те, кто пропустил встречу. Ученик примет любую фразу конспекта за совет и сделает по ней. Этот абзац объясняет все запреты ниже: каждый защищает ученика от совета, которого на встрече не было.
Кто говорит. Распознавание не знает имён и ставит метки голосов. Программа считает, у какой метки больше всего текста, и подставляет строку вида «S1 это, скорее всего, Серёжа Рис, автор программы: он ведёт встречу». Остальные голоса принадлежат участникам. Их рассказ модель пишет как опыт участника. Советом для учеников он становится, только если я сам это советую. Без этого абзаца самая частая ошибка модели была одна: она подавала рассказ участника как мой совет. Этот случай подробно разобран в гайде про эвалы.
Чего нельзя писать про людей. Имена, ники, страну, город, банк и карту, работодателя, семью, здоровье, деньги. Имён из чата модель не видит: программа ещё до промпта меняет их на слово «участник», а ссылки участников на пометку «[ссылка участника]». Имена, сказанные вслух, остаются в расшифровке, поэтому запрет в промпте всё равно нужен.
Как писать. Конспект читают без записи, поэтому в нём приём, зачем он и как его сделать. Кто что показал и в каком порядке, ученику не нужно. Отдельная строка про уверенность: «обычно» и «можно» не превращаются в «всегда» и «нужно». Её добавили после замера: модели усиливали сказанное.
Замок текста. Так называется проверка, которую программа запускает после ответа. Она ловит длинное тире, противопоставления с «не» и «а», жирный шрифт и слова из моего словаря замен. Правила стоят и в промпте, чтобы модель сразу писала по ним, а проверка ловила остатки.
Объём и форма. Около 24 слов на минуту записи: на полуторачасовой урок выходит примерно 2200 слов. Разделы идут в порядке встречи, заголовок называет суть. Ответ ровно из трёх блоков: конспект, главы, описание. По этим блокам программа сама раскладывает ответ по файлам. Домашка попадает в конспект, только если её дали на встрече. Ответы на вопросы «проверь себя» должны быть в самом конспекте.
Что программа подставляет в пропуски
- WHAT, LABEL, DATE_HUMAN, DURATION_MIN: какая встреча, дата и длина записи.
- TOPIC_NOTE: тема урока по расписанию и фраза о формате: Серёжа объясняет и показывает, участники задают вопросы и делают практику.
- SPEAKERS: какая метка голоса моя. Если распознавание голоса не различило, здесь так и сказано: меток нет, реплики участников узнавай по смыслу.
- WORDS: объём, 24 слова на минуту записи.
- WORDS_MAP: словарь замен из моих правил письма. Слева калька с английского или канцелярит, справа слово, которым его заменить.
- TERMS: как пишутся названия инструментов: Claude Code, Codex, GLM и другие.
- CHAPTER_FORMAT: как оформить главы. Сколько их может быть, программа считает по длине записи. Если встреча это урок, у каждой главы есть ещё часть урока и отметка практики.
- POST_TOPICS: до пяти тем для утреннего поста в группе.
- CHAT и TRANSCRIPT: чат встречи без имён и расшифровка строками «[время метка] реплика».
Что проверяет программа
Ответ модели сначала проверяет программа. Смысл она не понимает, ей хватает правил:
- все три блока на месте, разделов хватает;
- нет длинного тире, противопоставлений с «не» и «а», жирного шрифта и слов из словаря замен;
- названия инструментов написаны правильно;
- каждая глава начинается там, где начинается реплика, и глав не больше, чем позволяет длина записи.
Время глав модель называет примерно, и программа ставит его на начало ближайшей реплики. Модель хорошо понимает смысл и плохо считает минуты. Про это у меня есть отдельный пост.
Если проверка не прошла, модель получает только строки с замечаниями и переписывает их. Остальной текст она не видит и не трогает. У неё две попытки. Противопоставления модели иногда так и не убирают, тогда программа сама режет фразу на два утверждения.
Конспект {{WHAT}} для учеников Personal Corp 3 не прошёл проверку текста. Ниже строки конспекта с замечаниями. Перепиши каждую так, чтобы замечание ушло, а смысл и факты остались прежними. Остальной текст не трогай.

Подсказки: длинное тире «—» заменяй двоеточием, точкой или запятой; оборот «не X, а Y» или «X, а не Y» перестрой в два отдельных утверждения, после отрицания без «, а» (замок ловит запятую с «а» в пределах 45 знаков после «не»); калька и синоним заменяются словом, которое назвала проверка; название скилла или файла можно взять в обратные кавычки.

{{PROBLEMS}}

Ответ: только исправленные строки, каждая в своём блоке, номер строки тот же:

===СТРОКА <номер>===
<новый текст строки целиком>

Если замечание про раздел целиком, верни раздел полностью, с заголовком:

===РАЗДЕЛ <заголовок раздела>===
## <заголовок>
<текст раздела>
Что написано в промпте критика
Дальше конспект читает критик. Он ищет то, что навредит ученику или собьёт его. Стиль он не правит, им уже занялась программа.
Ты проверяешь конспект {{WHAT}} потока Personal Corp 3 ({{DATE_HUMAN}}) перед публикацией ученикам. Человек его не увидит: твои исправления код вставит в текст, а по оставшимся ошибкам решит, публиковать ли.

{{SCOPE}} {{SPEAKERS}} Остальные голоса — участники потока. Стиль и выбор слов не правь: словарь программы задан, текст проверяют отдельно.

Ищи то, что ученику навредит или собьёт его:
- `unsupported`: утверждение, цифра, инструмент, совет или обещание, которого в расшифровке нет или сказано иначе;
- `attribution`: опыт или мнение участника подано как совет программы или слова Серёжи, или наоборот;
- `privacy`: по тексту можно узнать участника: имя, ник, страна, город, банк и карта, работодатель, семья, здоровье, деньги, его ссылки; реквизиты встречи;
- `term`: название инструмента или модели записано неверно (смотри список терминов);
- `chapter`: глава начинается не там, где начинается её тема (смотри минуту после времени главы), или название не про то;
- `missing`: тема, которой на встрече отдали больше пяти минут, не попала ни в конспект, ни в главы;
- `homework`: «ДЗ» расходится с тем, что сказали про домашку.
- `practice`: в метаданных главы practice=true, хотя ученикам не предлагают действовать в этом интервале; показ Серёжи и обсуждение домашки сами по себе практикой не являются. Проверь подтверждающую реплику и контекст. Это critical; исправление метаданных не вставляется автоматически, публикация останавливается.

Серьёзность: `critical` — ложь, обратный смысл, выдуманное обещание, приватные данные; `major` — заметная неточность, чужой опыт подан советом, неверная глава, пропуск крупной темы; `minor` — мелкая неточность.

Для каждой ошибки дай исправление:
- `quote`: фрагмент конспекта, который надо заменить, скопированный дословно (одно-два предложения; для главы — строка вида `12:34 Название`);
- `fix`: текст на его место (пустая строка — удалить фрагмент; для главы — строка `M:SS Название` с верным временем строки расшифровки); для `missing` — `quote` это последнее предложение раздела, после которого вставить, а `fix` — оно же плюс новые предложения;
- исправление пишется по тем же правилам, что конспект: без длинного тире «—», без «не X, а Y», без имён участников.

Ответ: только JSON, без пояснений вокруг:
{"issues": [{"severity": "critical|major|minor", "kind": "...", "quote": "...", "fix": "...", "evidence": "MM:SS что в расшифровке"}], "summary": "одна строка"}

Термины: {{TERMS}}

Чат встречи: {{CHAT}}

Главы:
{{CHAPTERS}}

Конспект:
{{LESSON}}

Расшифровка, строка = [время метка] реплика:

{{TRANSCRIPT}}
Виды ошибок названы заранее. Выдумка, слова, приписанные не тому человеку, личные подробности, неверное название, глава не на месте, пропущенная большая тема, неверная домашка, ложная практика. Критик ищет по этому списку.
У каждой ошибки вес. Критичная: ложь, обратный смысл, выдуманное обещание, личные данные. Серьёзная: заметная неточность, чужой опыт под видом совета, неверная глава, пропуск большой темы. Мелкая: всё остальное. Если после правок осталась хоть одна критичная ошибка или больше двух серьёзных, страница не выходит. Мне в Telegram приходит сообщение с причиной.
Ошибка приходит с исправлением. На каждую ошибку критик даёт дословный кусок конспекта, текст на замену и место в расшифровке, где видно, что сказали на встрече. Программа находит кусок, вставляет замену и снова запускает проверки. Если замена что-то сломала, текст откатывается к версии до критика.
Практика проверяется отдельно. Глава урока может быть отмечена как практика: здесь ученику предлагают сделать что-то самому. Для такой главы модель обязана привести дословную реплику с заданием. Показ на экране практикой не считается. Ошибка здесь критичная, и выпуск останавливается.
Критику лучше быть из другой семьи. Модель мягче к текстам своей семьи, то есть моделей той же компании. Это видно в замере из гайда про эвалы. Поэтому по возможности критик от другой компании. Сейчас на сервере есть ключ только одной компании, Z.ai, и конспект пишет и проверяет одна и та же модель.
Какие правила здесь работают
Эти правила годятся для любого пересказа, который потом читают люди: протокола созвона, сводки чата, выжимки из договора. Правила про выбор модели и замер собраны в гайде про эвалы.
Скажите, кто прочитает текст и что с ним сделает
Назовите в начале промпта читателя и цену ошибки. Тогда каждый запрет дальше вытекает из этой фразы. Как с копирайтером: текст для витрины и текст для инструкции к прибору пишут по-разному.
Чего модель не видела, того она не перескажет
Имена и личные ссылки убирайте до промпта. Запрет в задании модель может нарушить. Имя, которого в промпте нет, она не перескажет. Как с анонимными экзаменационными работами: фамилию закрывают до того, как работу увидит проверяющий.
Просите ответ в форме, которую проверит программа
Три блока с метками, главы строками со временем, ошибки критика списком полей. Тогда программа сама разберёт ответ, проверит его и вставит исправления. Как с бланком в банке: поля сверяют за секунду, письмо в свободной форме читают целиком.
Просите исправление вместе с ошибкой
Пусть проверяющая модель даёт кусок текста, замену и доказательство. Замечание «тут неточно» исправлять некому. Готовую замену вставит программа. Как корректор: он правит прямо в тексте и не пишет на полях «плохо».
Решите заранее, когда остановить выпуск
Запишите, какие ошибки останавливают выпуск. Тогда «публиковать или нет» решает правило, и поправить его можно один раз для всех выпусков. Как отдел контроля на заводе: брак откладывают по допуску, одинаково в любую смену.
На чём мы споткнулись
Названия глав не проверялись. В пробной попытке 30 сентября программа проверяла язык конспекта и пропускала названия глав. В одной главе осталось английское сокращение. Теперь главы проходят тот же замок, что и конспект.
Модель усиливала сказанное. Осторожная мысль в конспекте становилась правилом. Это поймал замер, и в промпте появилась строка про степень уверенности.
Меток голосов может не быть. С 14 октября, если ElevenLabs не ответил, сервер переходит на свой распознаватель. Голоса он не различает. Промпт это учитывает: вместо строки про мою метку модель получает «меток нет, реплики участников узнавай по смыслу и не приписывай их Серёже».
Противопоставления модели любят. Такая фраза переживает и промпт, и исправление. Поэтому последнее слово за программой.
Как повторить у себя
- Расшифруйте запись. Нужен текст, где у каждой реплики есть время. Если распознавание различает голоса, ещё лучше. Как выбрать сервис, рассказано в гайде про расшифровку.
- Уберите имена из чата. Замените имена участников словом «участник» до того, как отдадите чат модели.
- Поменяйте в промпте своё. Название программы, своё имя, список терминов, объём. Остальные строки можно оставить.
- Отдайте промпт одним сообщением. Расшифровку и чат вставьте в конец промпта. Файлы и инструменты модели не нужны.
- Проверьте конспект промптом критика в другой модели. Писал Claude, пусть проверяет ChatGPT, и наоборот.
- Вставьте замены. Критик даёт кусок текста дословно, поэтому его найдёт обычный поиск. Агент вставит все замены за один раз.
В этом пайплайне человек остался в двух местах. Я решил, что считать ошибкой, и получаю сообщение, если страница не вышла. Остальное делают модель в роли автора, модель в роли критика и программа, которая не верит им на слово.
Возьмите промпты себе, поменяйте имена и попробуйте на своей записи. Что получилось, расскажите в чате вайбкодеров. Пайплайны вроде этого собираем в Personal Corp. Подробнее в боте.
Распознавание: ElevenLabs Scribe. Модели на сервере: GLM от Z.ai. Соседние гайды: Эвалы: как проверить нейросеть на своей задаче, Как расшифровать видео и аудио, пост про главы из транскрипта. Промпты приведены в том виде, в каком работают на сервере. Пример на первом экране взят из настоящего конспекта, имён участников в нём нет.