TypeSafe выпустила Jev: модель ИИ для выбора действий
Содержание
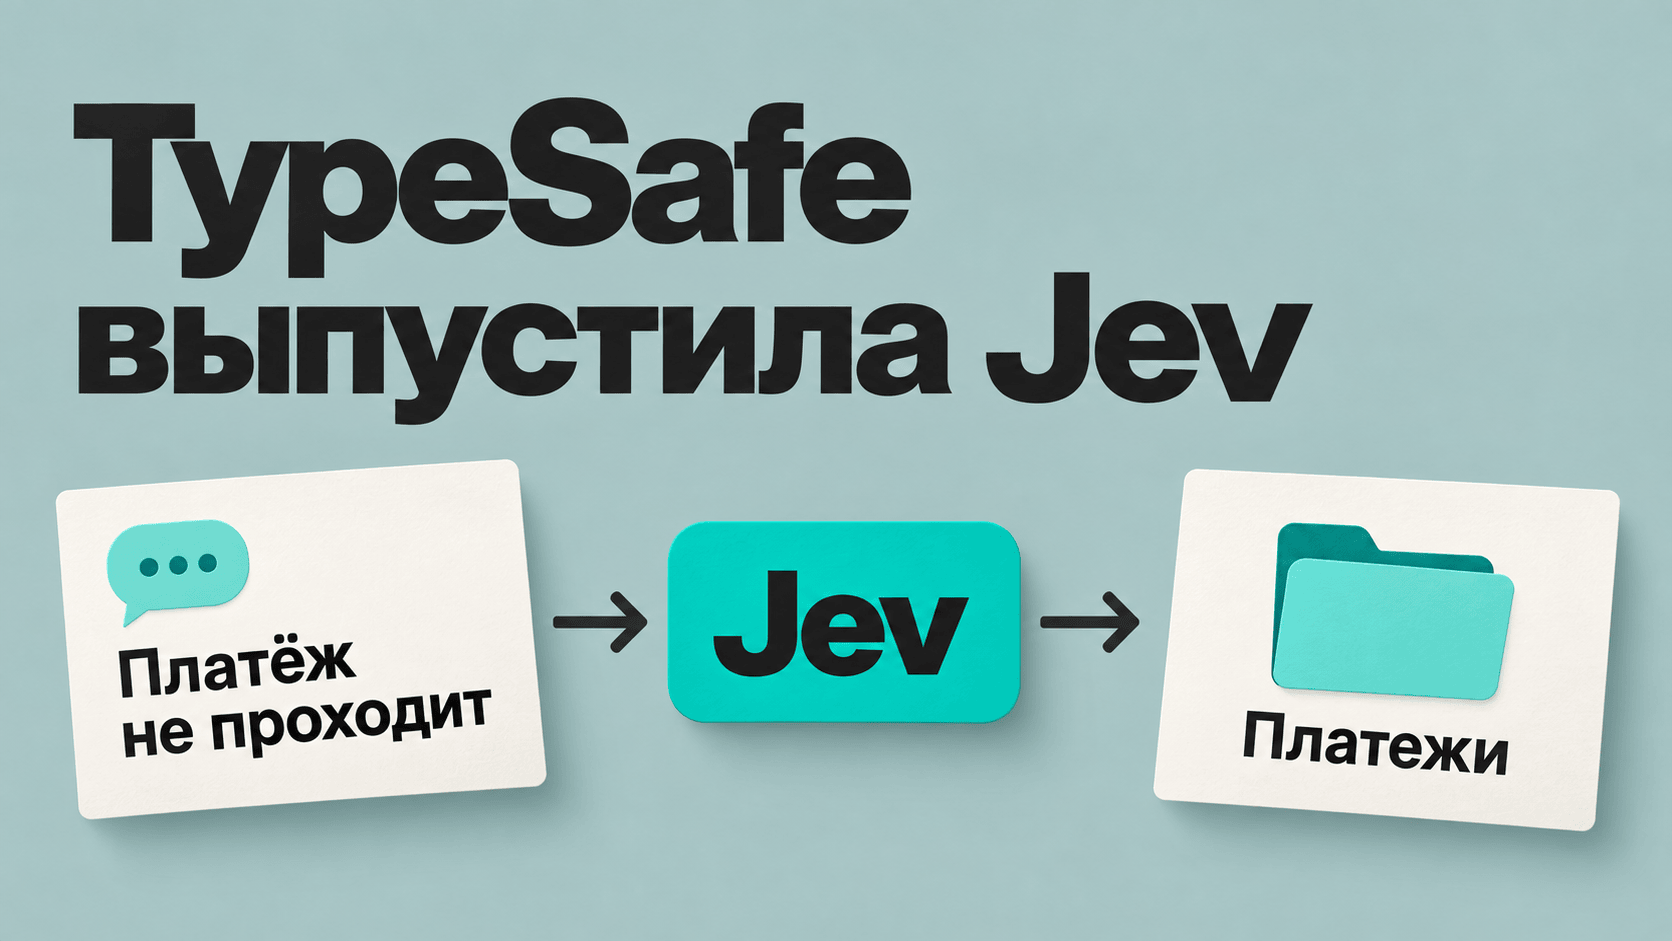
TypeSafe выпустила Jev: модель ИИ, которая выбирает действие из заданных вариантов и оценивает ситуацию. Она помогает распределять обращения и выбирать следующие шаги в играх и помощниках.
15 сентября 2026 года TypeSafe представила Jev, модель искусственного интеллекта для выбора действий и оценки ситуаций. Она может определить, кому передать обращение клиента, какое действие предложить помощнику или когда нужна проверка человеком. Модель выбирает из заданных вариантов и может учитывать относящуюся к вопросу историю.
Для компаний смысл такого подхода в повторяющихся решениях: распределении запросов, оценке срочности, проверке работы автоматических помощников. Попробовать Jev можно в нашем Telegram-боте @jev_robot, без установки программ и собственного ключа доступа.
Как Jev разбирается с обращением клиента
Представь сообщение: «Платёж не проходит третий день». Компания может поручить Jev распределение обращений. Команда сервиса заранее задаёт три отдела: поддержка, продажи, платежи. Сообщение клиента становится входом для модели; вопрос звучит так: кому его передать?
Jev сравнивает текст с заданными вариантами и возвращает выбранный отдел вместе с вероятностями вариантов. После этого приложение может направить обращение соответствующему сотруднику. Сотрудник проверяет проблему и занимается её решением. Цель и правила задаёт команда компании, выбор предлагает модель, передачу выполняет программа.
Принцип распространяется на другие вопросы. Можно оценить срочность обращения по заданной шкале или спросить, сообщает ли человек о серьёзной проблеме. Для решения могут понадобиться история переписки, сведения о заказе и действующие правила. Объём и состав информации зависят от задачи; нужные связи и доказательства должны сохраниться.
Выбор из списка тоже бывает ошибочным
TypeSafe гарантирует ответ в заданной форме: например, один из разрешённых отделов. При этом сообщение о неудачном платеже может попасть в продажи. Сотрудник получит обращение, которое ему не предназначалось, и помощь задержится. Правильность выбора требуется проверять отдельно.
Вероятности показывают оценку модели. Высокая уверенность не освобождает от проверки: TypeSafe прямо предупреждает, что оценка надёжности на группе примеров не гарантирует отдельного ответа. Важны реальные ошибки на тех обращениях, с которыми работает сервис.
Для рискованных действий можно предусмотреть подтверждение человеком: например, перед отправкой письма или необратимым изменением данных. Если сведений мало, их нужно получить; сложный случай приложение может передать другой модели или человеку. Такой порядок задают создатели приложения.
Как проверить, что помощник действительно выполнил просьбу
ИИ-помощник может выполнять действия в программах: искать информацию, готовить сообщения, пользоваться браузером. TypeSafe предлагает проверять результаты такой работы. Обещание «письмо отправлено» само по себе ещё не подтверждает отправку.
Допустим, человек попросил отправить письмо. Для проверки этого действия нужны просьба, разрешение на отправку, адресат и ответ почтовой программы. Помощник готовит текст и предлагает действие; почтовая программа выполняет отправку по правилам приложения. Jev может оценить собранные сведения, а программа решит, закрыть задачу или передать её человеку.
В проверке TypeSafe отдельно оцениваются разрешения, выполнение задачи и удовлетворённость пользователя. Это разные вещи: действие может состояться, а человек остаться недоволен. Программе нужна относящаяся к вопросу история работы. Когда необходимой информации нет, успешный результат считать подтверждённым нельзя.
Что уже показали в играх и браузере
В демонстрации Doom команды TypeSafe Jev выбирает, что делать дальше в игре. Программа передаёт описание происходящего текстом, модель выбирает действие, игровая программа его исполняет. Изменившаяся ситуация становится следующим входом. Работа с изображением игрового экрана этим демо не показана.
Авторы Doom-демо оценивают темп в десять обращений к модели в секунду и расходы примерно в семь долларов в час. Это оценка их сценария: размер отправляемого текста, частота действий и дополнительные расходы меняют стоимость.
В Wikiracing команды TypeSafe задача состоит в переходе от одной статьи Wikipedia к другой по ссылкам. Jev выбирает следующую ссылку, программа открывает страницу, затем выбор повторяется. Самый короткий маршрут не гарантирован; опубликованный таймер исключает загрузку страниц.
В демо Browser Use программа искала рейсы Цюрих → Лондон. Jev выбирала действие и элемент страницы. Названия городов для заполнения полей генерировала другая модель, Mercury; действия в браузере выполняла программа. Авторы сообщают о 7,073 секунды, но таймер начинается после первого наблюдения страницы. Начальная навигация и независимая проверка результата не входят в это время; билеты не покупались.
В голосовом браузере Jev выбирает действие по распознанной команде и подписям элементов страницы.
Насколько убедительны первые результаты
В одном из первых опубликованных тестов команда сервиса fx сравнивала, как Jev и GPT-5.6 Luna оценивают безопасность команд автоматического помощника перед выполнением. Типичный ответ Jev занимал около 0,3 секунды, Luna отвечала примерно за 1,5 секунды. Jev в этом сравнении ошибалась реже; ошибки были у обеих моделей. Результат относится к этим примерам и условиям проверки.
TypeSafe также публикует собственные тесты обработки счетов, поддержки клиентов и других процессов. Ориентир для правильных ответов получен с помощью двух сильных ИИ-моделей. Их согласие не заменяет независимую проверку человеком. Подробности сравнения важны при оценке рекламируемых показателей скорости и цены.
Документация Jev перечисляет ошибки с математикой, датами, косвенными связями и противоречивыми условиями. Лишние сведения тоже могут мешать. Если несколько решений зависят друг от друга, проверять нужно весь путь и последствия неверного шага.
Сколько стоит использование
Цена TypeSafe на 17 сентября: $0,042 за миллион входных токенов, выход бесплатный. Токеном называют фрагмент текста, иногда часть слова. Поэтому расход зависит от объёма информации, переданной модели, и количества обращений. Из этого тарифа нельзя вывести цену одной произвольной проверки.
Для подключения через посредника Vercel карточка Gateway показывает $0,04 за миллион входных токенов; цена выхода там не указана. Другие модели в приложении оплачиваются отдельно. TypeSafe допускает субсидирование своего тарифа; его устойчивость не установлена.
Как попробовать самому
Открой наш @jev_robot в Telegram и нажми Start → «Разобрать пример». Сначала бот показывает задачу, условия и иллюстрацию. Кнопка «Проверить пример · 1 запрос» отправляет вопрос модели.
В карточке «Какую кнопку выбрать?» бот предлагает команду «открой документацию» и три элемента страницы: «Документация», «Войти», «Поиск». Команде соответствует ссылка «Документация». Модель возвращает свой выбор и вероятности вариантов; сравни ответ с этой целью. Бот показывает решение, браузерную кнопку он не нажимает.
Через «Проверить мою задачу» можно заменить исходный текст и посмотреть новый ответ при тех же условиях. «Все примеры» содержит пять учебных карточек: выбор кнопки, проверку команды помощника, режим модели, поиск функции по смыслу и риск изменения кода. Для собственного вопроса доступны выбор вариантов, оценка по шкале и да/нет. Эти проверки работают с текстовыми описаниями; бот не исполняет команды и не переключает модели.
На 17 сентября проба в боте бесплатная в пределах 20 запросов в сутки по UTC, со сбросом в 03:00 по Москве. Собственный ключ доступа не нужен. Просмотр карточек и сохранённого ответа квоту не расходует; обращение к модели списывает один запрос. Между запросами нужны десять секунд, текст ограничен 3000 символами. Доступ зависит от бюджета сервиса и доступности модели. Введённый текст и условия передаются через Vercel в TypeSafe; не отправляй секреты и личные данные.
Jev позволяет добавить осмысленный выбор в программу. Для пользователя важно, какие сведения получила модель, кто исполняет её решение и кто отвечает за ошибку. Начать знакомство можно с понятного примера в боте: задать цель, увидеть выбор и самостоятельно проверить, подходит ли он.
Подробности первых тестов и рекламируемых показателей
Команда fx проверяла 70 размеченных случаев по три раза. Jev дала 207 верных решений из 210, GPT-5.6 Luna дала 203. Медиана задержки составила 312 мс против 1458 мс, около 4,7×. Повторы зависимы; маркетинговые 193,6× и 444,6× здесь не воспроизводятся.
В анонсе TypeSafe заявлены 193,6× ускорения и 444,6× снижения стоимости в проверках целых процессов. Знаменатель и расчёт не раскрыты. Эти результаты не устанавливают выигрыш на других задачах. Диапазон 70-500 мс также является заявлением компании о задержке вызова.
Четыре теста включают инцидент безопасности, проверку агента поддержки, обработку счёта и обслуживание клиента. График усредняет их точность, цену и время с равным весом. Ориентир для ответов получен усреднением GPT-6 Astra и Fable 5.1 с высоким уровнем размышления. Другие модели используют настройки провайдера по умолчанию и обёртку для структурированных вероятностей. Этот ориентир не задаёт базу множителей скорости и цены. TypeSafe отмечает возможное смещение собственных тестов и запуск с ноутбуков на западном побережье США.
В Agent Trace Observability есть пример, в котором все три модели расходятся с эталоном. Независимая человеческая проверка эталона требуется отдельно. Browser Use ограничивает статистические выводы тремя парами прогонов. В Wikiracing более 255 ссылок требуют двухэтапного выбора.
Устройство ответов и оценка надёжности
Интерфейс TypeSafe называет входную информацию state, вопросы questions, ответы answers. Choice выбирает из заданных вариантов и возвращает их вероятности; Noul возвращает вероятность «да» от 0 до 1; Score вычисляет оценку по вероятностям упорядоченных уровней.
Confidence у Choice и Score характеризует распределение вероятностей; Noul отдельного confidence не возвращает. Калибровка проверяется на группе ответов и не гарантирует отдельного решения. Другие языковые модели тоже поддерживают заданные схемы; сравнивать нужно одинаковые задачи и настройки.
TypeSafe называет подход System One, а обучение RLCD: обучение с подкреплением для калиброванных решений. Опубликованный интерфейс не доказывает внутреннюю архитектуру модели.
Для создателей приложений: официальный skill и ai-cli
TypeSafe skill даёт агенту для работы с проектом инструкции для чтения документации, постановки типизированных вопросов и интеграции Jev. В Claude Code установка выполняется двумя командами:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
Для Codex и других поддерживаемых агентов, с Node.js и npx:
npx skills add typesafe-ai/skills --skill typesafe-aiКоманда предлагает выбрать агента; установка по умолчанию относится к текущему проекту. В Claude Code skill вызывается /typesafe:typesafe-ai, в другом агенте по имени. README предлагает маршрутизацию поддержки по отделам с передачей неоднозначных случаев человеку. Можно попросить агента подготовить такой сценарий на безопасном тестовом обращении. Skill не запускает автоматический контроль всех действий: порядок, пороги и исполнение остаются в приложении.
Для playground TypeSafe требуется вход. Прямой API использует ключ из настроек; доступ зависит от аккаунта. Vercel Gateway использует свой ключ или Vercel OIDC. Установка skill не выдаёт доступ к модели; ключи этих сервисов различаются и не должны попадать в публичные промпты или код.
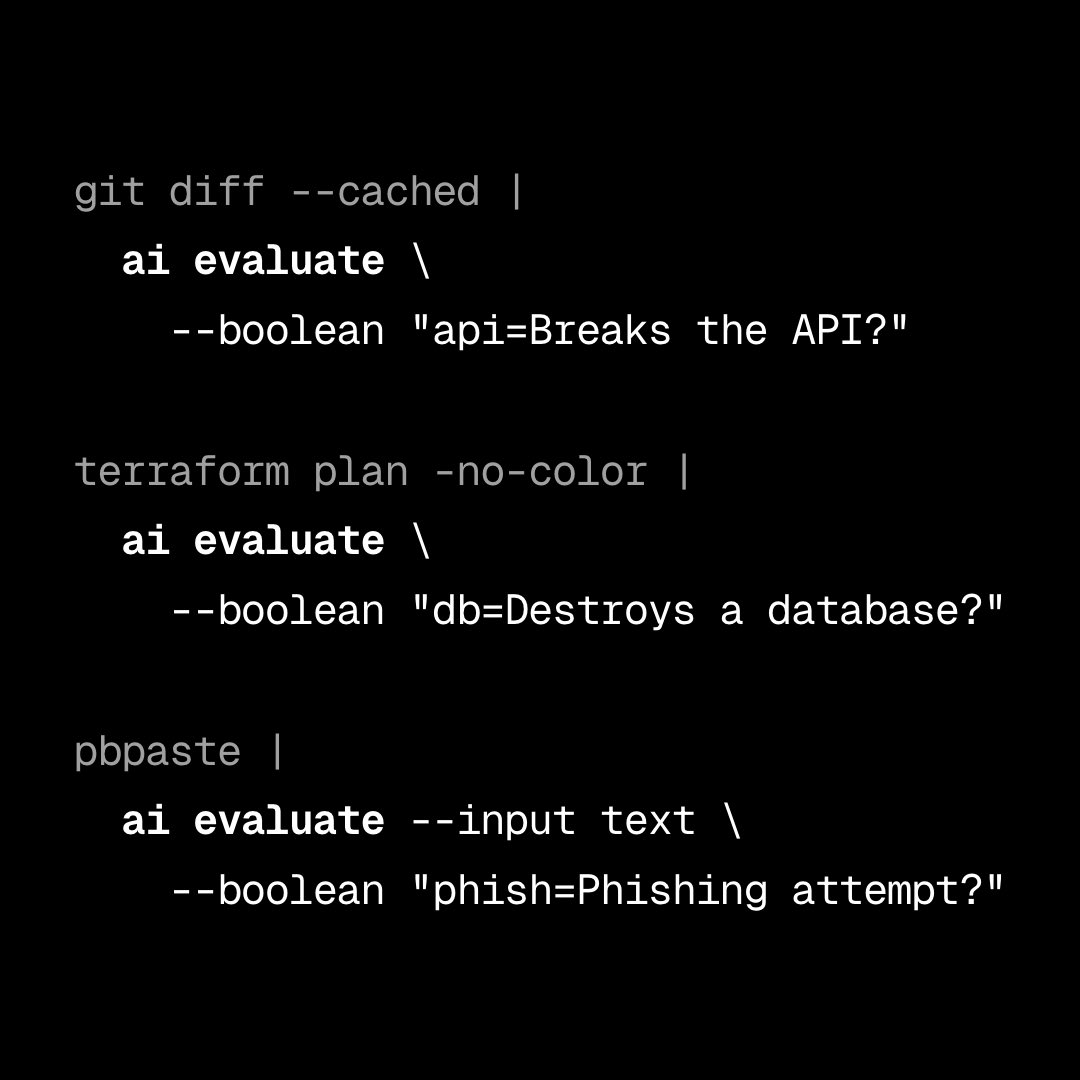
Chris Tate 17 сентября предложил ai-cli для обращения к Jev из терминала. ai-cli 0.5.1 требует Node.js 22+:
npm install -g ai-cliОценка через CLI требует AI_GATEWAY_API_KEY, доступа к Jev и средств Gateway; модель по умолчанию typesafe-ai/jev. Исходный пример Tate:
git diff --cached |
  ai evaluate \
    --boolean "api=Breaks the API?"
Команда передаёт подготовленные к коммиту изменения на Boolean-вопрос. JSON-ответ answers.api.probability означает P(true). Человек или следующий код принимает дальнейшее решение; успешное завершение команды не означает безопасный коммит. Для оценки нужны достаточный API-контракт и контекст потребителей, а также тесты совместимости. Перед отправкой проверь текст на секреты и личные данные. CLI принимает также Choice и Score; стоимость зависит от входа, вопросов и условий Gateway.
Источники
- TypeSafe: анонс Jev 15 сентября 2026 — Заявления команды о механизме, задержке, цене и workflow evals
- TypeSafe API reference — state/questions/answers и три типа вопросов
- TypeSafe confidence — Вероятности, уверенность и ограничения автоматического действия
- TypeSafe workflow evals — Четыре процесса, reference probabilities и режимы сравнения
- Ранний внутренний тест команды fx — 70 случаев, три повтора; Jev и GPT-5.6 Luna
- Browser Use: методика Jev Ultrafast — Границы таймера, текстовая модель Mercury и ограничения сценария
- TypeSafe: ограничения Jev 1.13 — Ошибки интерпретации и задачи, требующие отдельной проверки