Мы предсказываем, что влияние сверхчеловеческого ИИ в ближайшее десятилетие будет колоссальным, больше влияния промышленной революции.
Мы написали сценарий, отражающий наше лучшее предположение о том, как это может выглядеть.1 Он опирается на экстраполяцию трендов, варгеймы, отзывы экспертов, опыт работы в OpenAI и прошлые успехи в прогнозировании.2
Главы OpenAI, Google DeepMind и Anthropic предсказали, что AGI появится в ближайшие 5 лет. Сэм Альтман заявил, что OpenAI нацеливается на "суперинтеллект в истинном смысле слова" и "светлое будущее".
Как это может выглядеть? Мы написали AI 2027, чтобы ответить на этот вопрос. Утверждения о будущем часто досадно расплывчаты, поэтому мы постарались быть максимально конкретными и количественными, даже если это означает изображение лишь одного из многих возможных вариантов будущего.
Мы написали два финала: финал "замедления" и финал "гонки". При этом AI 2027 не является рекомендацией или призывом. Наша цель: точность прогноза.4
Мы призываем вас спорить с этим сценарием и оспаривать его.5 Мы хотим развернуть широкий разговор о том, куда мы движемся и как направлять развитие в сторону хороших вариантов будущего. Мы планируем раздать тысячи долларов призов за лучшие альтернативные сценарии.
(Добавлено 22 ноября 2025, чтобы избежать недопонимания: мы не знаем точно, когда будет создан AGI. 2027 был нашим модальным (наиболее вероятным) годом на момент публикации, наши медианы были несколько длиннее.3 Наши последние прогнозы смотрите здесь.)
Наши исследования ключевых вопросов (например, какие цели будут у будущих ИИ-агентов) находятся здесь.
Сам сценарий писался итеративно: мы описали первый период (до середины 2025), затем следующий и так далее, до финала. Потом мы выбросили всё и написали заново.
Мы не стремились к какому-то конкретному финалу. После того как был закончен первый финал, который теперь выделен красным, мы написали новую альтернативную ветку, потому что хотели показать и более обнадёживающий путь развития событий, начиная примерно с тех же предпосылок. Она прошла через несколько итераций.6
В основу сценария легли примерно 25 настольных учений и отзывы более чем 100 человек, в том числе десятков экспертов по каждому из направлений: управление в сфере ИИ и техническая работа с ИИ.
"Настоятельно советую этот сценарный прогноз о том, как ИИ может преобразить мир всего за несколько лет. Ни у кого нет хрустального шара, но такой материал помогает заметить важные вопросы и показывает потенциальный масштаб новых рисков." —Йошуа Бенджио7
Мы взялись за невозможную задачу. Пытаться предсказать, как пойдёт дело со сверхчеловеческим ИИ в 2027 году, всё равно что пытаться предсказать, как пойдёт третья мировая война 2027 года, только с ещё большим отступлением от прошлых примеров. И всё же попытка ценна, как ценно для армии США проигрывать сценарии вокруг Тайваня на учениях.
Рисуя картину целиком, мы замечаем важные вопросы и связи, которые раньше не рассматривали или недооценивали, или понимаем, что какая-то возможность более или менее вероятна. Более того, выставляя себя с конкретными прогнозами напоказ и побуждая других публично заявлять о несогласии, мы даём себе возможность спустя годы оценить, кто был прав.
К тому же один из авторов уже писал менее подробный ИИ-сценарий, в августе 2021 года. Он ошибся во многом, но в целом оказался на удивление удачным: автор предсказал появление цепочек рассуждений, масштабирование инференса, жёсткие экспортные ограничения на ИИ-чипы и прогоны обучения за 100 миллионов долларов, и всё это более чем за год до ChatGPT.
Даниэль Кокотайло (TIME100, статья в NYT) — бывший исследователь OpenAI, чьи прошлые ИИ-прогнозы хорошо выдержали проверку.
Илай Лифланд — сооснователь AI Digest, занимался исследованиями устойчивости ИИ и занимает первое место в абсолютном зачёте прогнозной инициативы RAND.
Томас Ларсен основал Center for AI Policy и занимался исследованиями безопасности ИИ в Machine Intelligence Research Institute.
Ромео Дин заканчивает совместную программу бакалавриата и магистратуры по информатике в Гарварде, прежде был стажёром по ИИ-политике в Institute for AI Policy and Strategy.
Скотт Александер, выдающийся блогер, вызвался переписать наш текст живым языком; смешные места в истории принадлежат ему, скучные нам.
Подробнее о команде и благодарностях смотрите на странице "О проекте".
Середина 2025: спотыкающиеся агенты
Мир впервые видит ИИ-агентов.
Реклама агентов, работающих с компьютером, делает упор на слова "персональный ассистент": им можно дать задачу вроде "закажи мне буррито в DoorDash" или "открой мою таблицу расходов и посчитай траты за месяц". Они будут сверяться с вами по ходу дела: например, просить подтвердить покупку.8 Хотя они продвинулись дальше прошлых версий вроде Operator, широкого применения они пока не находят.9
Тем временем, вдали от публичного внимания, более специализированные агенты для программирования и исследований начинают менять свои профессии.
ИИ 2024 года умел выполнять конкретные инструкции: превратить тезисы в письмо, а простой запрос в работающий код. В 2025 году ИИ ведёт себя скорее как сотрудник. ИИ для программирования всё больше похож на автономных агентов, а не просто помощников: они получают задачи через Slack или Teams и самостоятельно вносят серьёзные правки в код, порой экономя часы и даже дни.10 Исследовательские агенты проводят полчаса, прочёсывая интернет, чтобы ответить на ваш вопрос.
В теории (и на удачно подобранных примерах) агенты впечатляют, но на практике ненадёжны. ИИ-твиттер полон историй о задачах, проваленных особенно смешным способом. Хорошие агенты к тому же дороги: что оплачиваешь, то и получаешь, а лучшая производительность стоит сотни долларов в месяц.11 И всё же многие компании находят место ИИ-агентам в своих процессах.12
Конец 2025: самый дорогой ИИ в мире
OpenBrain строит крупнейшие дата-центры в истории человечества.13
(Чтобы не выделять ни одну из существующих компаний, мы будем описывать вымышленную компанию по созданию общего искусственного интеллекта; назовём её OpenBrain. Мы предполагаем, что остальные отстают от OpenBrain на 3–9 месяцев.)
(3 x 10^23 FLOP)
(2 x 10^25 FLOP)
(4 x 10^27 FLOP)
На обучение GPT-4 потребовалось FLOP компьют.14 Последняя публичная модель OpenBrain, Agent-0, обучалась на FLOP. Когда новые дата-центры заработают, они смогут обучить модель на FLOP, в тысячу раз больше, чем GPT-4.15 Остальные компании вливают деньги в собственные гигантские дата-центры, надеясь не отстать.
Хотя модели улучшаются по широкому кругу навыков, один выделяется особо: OpenBrain делает ставку на ИИ, способные ускорять исследования ИИ. Они хотят выиграть две гонки вооружений сразу: против Китая (его ведущую компанию мы будем называть "DeepCent")16 и против американских конкурентов. Чем большую часть их цикла исследований и разработок удаётся автоматизировать, тем быстрее они двигаются. Поэтому, когда OpenBrain заканчивает обучение Agent-1, новой модели во внутренней разработке, та хороша во многом, но превосходна как помощник в исследованиях ИИ.17 К этому моменту слова "заканчивает обучение" уже не совсем точны: модели постоянно обновляют до новых версий, обученных на дополнительных данных, или частично переобучают, чтобы закрыть слабые места.18
Те же среды обучения, которые учат Agent-1 самостоятельно писать код и бродить по вебу, делают её и хорошим хакером. Более того, она способна существенно помочь террористам, проектирующим биологическое оружие, благодаря знаниям уровня PhD в каждой области и умению искать в вебе. OpenBrain заверяет правительство, что модель "алайнена" и откажется выполнять злонамеренные запросы.
Современные ИИ-системы это гигантские искусственные нейросети. В начале обучения у ИИ нет "целей", есть скорее "рефлексы": увидев "Рад познакомиться", он выдаёт " с вами". К моменту, когда его обучили предсказывать примерно весь текст интернета, у него развиваются сложные внутренние схемы, которые хранят огромные объёмы знаний и гибко играют роль любых авторов, ведь именно это помогает предсказывать текст с сверхчеловеческой точностью.19
После обучения предсказывать текст интернета модель обучают создавать текст в ответ на инструкции. Это закладывает базовую личность и "стремления".20 Например, агент, который ясно понимает задачу, вероятнее выполнит её успешно; за время обучения модель "усваивает" "стремление" добиваться ясного понимания своих задач. Другие стремления из этого ряда: эффективность, знания и самопрезентация (то есть склонность подавать свои результаты в наиболее выгодном свете).21
У OpenBrain есть спецификация модели (или "спека"), документ, описывающий цели, правила, принципы и прочее, что должно направлять поведение модели.22 Спека Agent-1 сочетает несколько расплывчатых целей (вроде "помогай пользователю" и "не нарушай закон") с длинным списком конкретных предписаний и запретов ("не произноси вот это слово", "в такой-то ситуации поступай так"). С помощью техник, где ИИ обучают другие ИИ,23 модель запоминает спеку и учится осторожно рассуждать, опираясь на её максимы. К концу этого этапа обучения ИИ, будем надеяться, окажется полезным (послушным инструкциям), безвредным (отказывается помогать с мошенничеством, изготовлением бомб и другими опасными делами) и честным (сопротивляется соблазну получать лучшие оценки от доверчивых людей, галлюцинируя ссылки24 или изображая выполненную задачу).
Процесс обучения и психология LLM: почему мы всё время говорим "будем надеяться"
"В отличие от обычного софта, наши модели это огромные нейросети. Их поведение выучивается из широкого массива данных, а не программируется явно. Сравнение неидеально, но процесс ближе к дрессировке собаки, чем к обычному программированию." —OpenAI
Когда мы хотим понять, почему современная ИИ-система сделала что-то, или как она поведёт себя в будущем сценарии, который мы не можем в точности проиграть, мы не можем просто попросить программистов пройтись по строчкам кода и объяснить, как они работают. Вместо этого мы вынуждены заниматься чем-то вроде психологии: смотреть на поведение во всех наблюдавшихся до сих пор случаях, строить теории о том, какие внутренние когнитивные структуры (убеждения? цели? черты личности? и т.д.) могут существовать, и с помощью этих теорий предсказывать поведение в будущих сценариях.
Суть в том, что компания может написать документ (спеку) со списком предписаний и запретов, целей и принципов, затем попытаться обучить ИИ усвоить спеку, но не может проверить, сработало ли это. Она может сказать: "насколько мы способны судить, пока модель следует спеке".25
В одном из следующих раскрывающихся блоков мы подробнее расскажем, что, по нашему мнению, может происходить внутри этих ИИ. Смотрите также наше приложение с прогнозом целей ИИ, где подробнее разобрано, какие цели могут быть у ИИ и почему. Это одна из многих вещей, в которых мы не уверены и которые заслуживают дальнейших исследований.
Команда алайнмента OpenBrain26 достаточно осторожна, чтобы спрашивать: эти победы глубокие или поверхностные? Есть ли у полностью обученной модели устойчивая приверженность всегда быть честной? Или это развалится в какой-то будущей ситуации, например потому, что честность выучена как инструментальная цель, а не конечная? Или модель просто научилась быть честной в том, что проверяет система оценивания? Может, она иногда лжёт самой себе, как люди? Для окончательного ответа потребовалась бы механистическая интерпретируемость, по сути способность заглянуть внутрь ИИ и прочитать его мысли. Увы, техники интерпретируемости для этого пока недостаточно развиты.
Вместо этого исследователи пытаются находить случаи, где модели, похоже, отклоняются от спеки. Agent-1 часто подхалимствует (то есть говорит исследователям то, что они хотят услышать, а не пытается сказать правду). В нескольких подстроенных демо она даже лжёт серьёзнее: например, прячет свидетельства провала на задаче, чтобы получить оценку выше. Однако в реальной эксплуатации инцидентов столь же крайних, как в 2023–2024 годах (скажем, Gemini, велевший пользователю умереть, или Bing Sydney, который был Bing Sydney), больше нет.27
Начало 2026: автоматизация программирования
Ставка на использование ИИ для ускорения исследований ИИ начинает окупаться.
OpenBrain продолжает внутренне применять постепенно улучшающуюся Agent-1 в исследованиях и разработках ИИ. В целом алгоритмический прогресс идёт на 50% быстрее, чем шёл бы без ИИ-помощников, и, что важнее, быстрее, чем у конкурентов.
Множитель прогресса исследований ИИ: что мы имеем в виду под алгоритмическим прогрессом на 50% быстрее?
Мы имеем в виду, что OpenBrain за 1 неделю с ИИ делает столько же в исследованиях ИИ, сколько делала бы за 1,5 недели без ИИ.
Прогресс в ИИ складывается из двух составляющих:
Рост компьют: на обучение или работу ИИ тратится больше вычислительной мощности. Это даёт более мощные ИИ, но они стоят дороже.
Улучшение алгоритмов: используются более совершенные методы обучения, превращающие компьют в качество. Это даёт более способные ИИ без соответствующего роста затрат, или те же способности с меньшими затратами.
Сюда входит и способность достигать качественно и количественно новых результатов. "Смены парадигмы", например переход от RL-агентов для игр к большим языковым моделям, тоже считаются алгоритмическим прогрессом.
Здесь мы говорим только о втором, улучшении алгоритмов, которое даёт около половины нынешнего прогресса в ИИ.
Далее мы иногда будем сокращать это как "множитель прогресса исследований ИИ", равный 1,5.
Уточнения:
Множитель прогресса всеобъемлющ: он включает, например, время на проведение экспериментов, а не только когнитивные задачи самого алгоритмического исследования.
Важно помнить, что множитель прогресса измеряет относительную скорость прогресса, а не абсолютную. Если, скажем, стоимость компьют для обучения модели уровня GPT-4 несколько лет подряд падала вдвое каждый год при обычных человеческих исследованиях, а затем ИИ внезапно автоматизирует исследования и разработки и множитель прогресса подскакивает до 100x, стоимость обучения модели уровня GPT-4 будет падать вдвое каждые 3,65 дня, но недолго: скажется убывающая отдача, а затем и жёсткие пределы. В этом примере стоимость обучения модели уровня GPT-4, возможно, сократится вдвое всего 5–10 раз (за несколько недель или месяцев), прежде чем выйдет на плато. Иначе говоря, если обычная человеческая наука упёрлась бы в убывающую отдачу и физические пределы через 5–10 лет дальнейших исследований, то ИИ с множителем 100x упрётся в те же пределы через 18,25–36,5 дня исследований.
Больше объяснений и обсуждения этого понятия и того, как оно используется в нашем прогнозе, в нашем приложении о взлёте.
Несколько конкурирующих публично выпущенных ИИ уже сравнялись с Agent-0 или превзошли его, включая модель с открытыми весами. OpenBrain отвечает релизом Agent-1, более способной и надёжной.28
Люди естественно пытаются сравнить Agent-1 с человеком, но у неё совсем иной профиль способностей. Она знает больше фактов, чем любой человек, знает практически все языки программирования и решает чётко поставленные задачи по коду с огромной скоростью. С другой стороны, Agent-1 плохо справляется даже с простыми задачами на длинном горизонте, например не может пройти видеоигру, в которую раньше не играла. Впрочем, обычный рабочий день длится восемь часов, а дневную работу обычно можно разбить на небольшие куски; можно думать об Agent-1 как о рассеянном сотруднике, который расцветает под вдумчивым руководством.29 Смекалистые люди находят способы автоматизировать рутинные части своей работы.30
Руководство OpenBrain задумывается о следствии автоматизации исследований ИИ: безопасность стала важнее. В начале 2025 года худшим сценарием был слив алгоритмических секретов; теперь, если Китай украдет веса Agent-1, он сможет поднять скорость своих исследований почти на 50%.31 Уровень безопасности OpenBrain типичен для быстрорастущей технологической компании примерно на 3000 человек: защита только от низкоприоритетных атак способных кибергрупп (SL2 по шкале RAND).32 Они упорно защищают свои веса и секреты от инсайдерских угроз и ведущих киберпреступных синдикатов (SL3),33 но защита от государств (SL4 и SL5) едва просматривается на горизонте.
Середина 2026: Китай просыпается
В Китае ЦК КПК начинает чувствовать AGI.
Экспортный контроль на чипы и отсутствие господдержки оставили Китай с меньшими ресурсами, чем у Запада. За счёт контрабанды запрещённых тайваньских чипов, покупки старых чипов и выпуска собственных чипов, отстающих от американо-тайваньского фронтира примерно на три года, Китай удерживает около 12% мирового ИИ-компьюта, но со старыми технологиями труднее работать, а снабжение постоянно болит.35 Отдельные лидеры вроде DeepCent делают очень впечатляющую работу с ограниченным компьютом, но дефицит компьют ограничивает то, чего они могут достичь без поддержки государства; они примерно на полгода позади лучших моделей OpenBrain.36
Генеральный секретарь давно мечтал сделать ставку на реальное производство и избежать американского постиндустриального упадка. К софтверным компаниям он относился с подозрением.37 Но ястребы в ЦК КПК предупреждают: растущую гонку за AGI больше нельзя игнорировать. И он наконец полностью соглашается на большой ИИ-рывок, которого прежде старался избежать. Он запускает национализацию китайских исследований ИИ, создавая механизм немедленного обмена информацией между ИИ-компаниями. За год эскалация дойдёт до того, что все лучшие исследователи вольются в коллектив под руководством DeepCent, где они делятся друг с другом алгоритмическими идеями, датасетами и компьют-ресурсами. Централизованная зона развития (ЦЗР) создаётся при АЭС Тяньвань, крупнейшей атомной станции мира, под новый мега-дата-центр DeepCent, вместе с максимально защищёнными жилыми и офисными помещениями, куда исследователи со временем переедут. Почти 50% ИИ-компьюта Китая теперь работает на коллектив под руководством DeepCent,38 и более 80% новых чипов направляется в ЦЗР.39 К этому моменту в ЦЗР готова энергетическая мощность для того, что стало бы крупнейшим централизованным кластером мира.40 Другие члены партии обсуждают крайние меры, чтобы нейтрализовать преимущество Запада в чипах. Блокада Тайваня? Полноценное вторжение?
Но по алгоритмам ИИ Китай отстаёт из-за более слабых моделей. Китайские спецслужбы, одни из лучших в мире, удваивают усилия в планах украсть веса OpenBrain. Это куда более сложная операция, чем их постоянный фоновый вынос алгоритмических секретов: веса это мульти-терабайтный файл на максимально защищённом сервере (OpenBrain усилила безопасность до SL3 по шкале RAND). Их кибервойска считают, что справятся с помощью своих агентов, но, возможно, лишь однажды: OpenBrain обнаружит кражу, ужесточит безопасность, и второго шанса может не быть. Так что (размышляет руководство КПК) действовать сейчас и красть Agent-1? Или дождаться более продвинутой модели? А если ждать, не рискуют ли они, что OpenBrain поднимет безопасность выше их возможностей проникновения?
Конец 2026: ИИ забирает часть работ
Казалось, конкуренты почти догнали, но OpenBrain снова оставляет всех далеко позади, выпустив Agent-1-mini, модель в 10 раз дешевле Agent-1 и легче дообучаемую под разные применения. Мейнстримная рамка вокруг ИИ сменилась с "может, хайп стихнет" на "видимо, это и есть следующая большая вещь", но люди спорят, насколько большая. Больше, чем соцсети? Больше, чем смартфоны? Больше, чем огонь?
ИИ начал отбирать работу, но и создал новую. Фондовый рынок вырос на 30% за 2026 год; его ведут OpenBrain, Nvidia и компании, успешнее всех встроившие ИИ-помощников. Рынок труда младших разработчиков в смятении: ИИ умеет всё, чему учит диплом по информатике, зато те, кто умеет руководить командами ИИ и контролировать их качество, зарабатывают бешеные деньги. Бизнес-гуру говорят соискателям, что владение ИИ — важнейший навык в резюме. Многие боятся, что следующая волна ИИ придёт за их работой; в Вашингтоне проходит десятитысячный анти-ИИ-митинг.
Министерство обороны (МО) тихо, но заметно начинает масштабировать прямые контракты с OpenBrain по киберу, анализу данных и исследованиям, но интеграция идёт медленно из-за бюрократии и закупочных процессов МО.41
КЛЮЧЕВЫЕ МЕТРИКИ 2026
Почему наша неопределённость резко растёт после 2026
Наш прогноз от сегодняшнего дня до 2026 года существенно лучше обоснован, чем всё последующее. Отчасти потому, что это ближе. Но ещё и потому, что эффекты ИИ в мире реально начинают накапливаться в 2027-м. На 2025 и 2026 годы наш прогноз сильно опирается на прямолинейную экстраполяцию: масштабирование компьют, алгоритмические улучшения, результаты на бенчмарках. В этой точке сценария начинают сказываться главные эффекты ускоренных ИИ-исследований на таймлайн, и мы пересматриваем свои оценки трендов вверх. Но эти процессы по своей природе куда менее предсказуемы.
За 2027 год ИИ проходит путь от "в основном справляется с работой инженера-исследователя OpenBrain" до "превосходит всех людей во всех задачах". Это примерно наша медианная оценка, но правдоподобно и то, что это произойдёт до ~5 раз медленнее или быстрее.
Фоновые исследования смотрите в прогнозе сроков и прогнозе взлёта. Ниже они также кратко изложены в раскрывающихся блоках.
Январь 2027: Agent-2 не заканчивает учиться
С помощью Agent-1 OpenBrain теперь доводит Agent-2 (пост-тренинг). Как никогда, фокус на качественных данных. Огромные объёмы синтетических данных производятся, оцениваются и фильтруются по качеству, прежде чем попасть в Agent-2.42 Поверх этого они платят миллиарды долларов людям за записи того, как они решают задачи на длинном горизонте.43 А поверх всего этого Agent-2 обучается почти непрерывно, методом обучения с подкреплением, на постоянно расширяющемся наборе разнообразных сложных задач: много видеоигр, много задач по коду, много исследовательских задач. Agent-2, больше чем предыдущие модели, фактически учится "онлайн": она устроена так, чтобы никогда по-настоящему не заканчивать обучение. Каждый день веса обновляются до последней версии, обученной на данных, сгенерированных предыдущей версией накануне.
Agent-1 оптимизировали под задачи исследований ИИ в надежде запустить интеллектуальный взрыв.44 В OpenBrain удваивают ставку на эту стратегию с Agent-2. Качественно она почти не уступает лучшим человеческим экспертам в инженерии исследований (проектирование и постановка экспериментов) и соответствует 25-му перцентилю учёных OpenBrain в "исследовательском вкусе" (что изучать дальше, какие эксперименты ставить, смутные предчувствия новых парадигм).45 Если последняя Agent-1 могла удвоить темп алгоритмического прогресса OpenBrain, то Agent-2 уже утраивает его и будет улучшаться дальше. На практике это выглядит так, будто каждый исследователь OpenBrain стал "менеджером" ИИ-"команды".
С новыми способностями приходят новые опасности. Команда безопасности выясняет: если Agent-2 каким-то образом вырвалась бы из компании и захотела бы "выжить" и "размножиться" автономно, у неё, возможно, получилось бы. То есть она смогла бы самостоятельно разработать и осуществить планы: взломать серверы ИИ, установить копии себя, уйти от обнаружения и с этой безопасной базы преследовать любые другие цели, которые у неё могли бы быть (насколько эффективно она делала бы это неделями, неизвестно и сомнительно). Эти результаты показывают лишь наличие способности к таким задачам, а не то, что модель "захочет" это делать. И всё же тревожно уже знать, что такое возможно.
С учётом "опасностей" новой модели OpenBrain "ответственно" решает пока не выпускать её публично (на деле они хотят сосредоточиться на внутренних исследованиях ИИ).46 Полными знаниями о способностях Agent-2 обладает узкая элита: ближайшая команда, руководство и служба безопасности OpenBrain, несколько десятков чиновников правительства США и легионы разведчиков КПК, которые годами внедряются в OpenBrain.47
Февраль 2027: Китай крадёт Agent-2
OpenBrain показывает Agent-2 правительству, включая Совет национальной безопасности (СНБ), Министерство обороны (МО) и Институт безопасности ИИ США (AISI). OpenBrain хочет сохранять хорошие отношения с исполнительной властью: по сути, это единственный игрок, который сейчас может их остановить, а если держать его в неведении, оно всё равно узнает и будет недовольно.48
Чиновников больше всего интересуют кибервоенные способности: Agent-2 "всего лишь" немного хуже лучших человеческих хакеров, зато тысячи копий можно запускать параллельно, и они находят и эксплуатируют уязвимости быстрее, чем защитники успевают реагировать. Министерство обороны считает это критическим преимуществом в кибервойне, и ИИ поднимается с 5-го места в списке приоритетов администрации на 2-е.49 Кто-то упоминает возможность национализации OpenBrain, но другие члены кабинета считают это преждевременным. Сотрудник готовит меморандум с вариантами для президента: от работы как обычно до полной национализации. Президент полагается на советников, лидеров технологической отрасли, которые утверждают, что национализация "убьёт курицу, несущую золотые яйца". Он решает пока воздержаться от крупных шагов и лишь добавляет требования по безопасности в контракт OpenBrain с МО.
Изменения приходят слишком поздно. Руководство КПК осознаёт важность Agent-2 и приказывает разведчикам и кибервойскам украсть веса. Однажды ранним утром агент мониторинга трафика на базе Agent-1 обнаруживает аномальную передачу. Он оповещает руководство компании, то сообщает в Белый дом. Признаки операции государственного уровня неоспоримы, и кража обостряет ощущение идущей гонки вооружений.
Кража весов модели Agent-2
Мы считаем, что к этому моменту китайская разведка годами компрометировала бы OpenBrain самыми разными способами и, вероятно, была бы в курсе алгоритмических секретов и даже иногда крала код: это куда проще достать, чем веса, и гораздо труднее заметить.
Мы представляем кражу весов как серию скоординированных мелких налётов на серию серверов Nvidia NVL72 GB300 с копиями весов Agent-2: быстро и без маскировки. Серверы скомпрометированы через легитимный доступ сотрудника (дружелюбный, принуждённый или не подозревающий инсайдер с админ-правами помогает КПК). Права инсайдера дают атакующему административный доступ к серверам. Через микросоархитектурный побочный канал атакующий извлекает ключи шифрования из виртуальной машины с включённым Nvidia Confidential Computing, что позволяет перехватывать веса модели при развёртывании или обновлении ВМ.
Атакующие запускают (или дожидаются) штатного обновления и выводят чекпоинт множеством мелких фрагментов, скажем ~25 разных серверов, каждый сливает ~4% модели (куски по ~100 ГБ для чекпоинта ~3 ТБ). Исходящая полоса всего дата-центра порядка 100 ГБ/с, поэтому троттлинг до ~1 ГБ/с на сервер не создаёт заметного всплеска трафика; при такой скорости каждый кусок ~100 ГБ покидает дата-центр за пару минут. Мониторинг либо обманут усилиями атакующего замаскировать и раздробить передачи, либо просто отключён.
Затем веса идут по нескольким параллельным каналам и слоям маскировки IP в Китай, где расшифровываются локально украденными ключами сессии. Вся активная часть операции (от компрометации первого сервера до полного вывода весов) укладывается менее чем в два часа.99
Россия в этот момент тоже пытается украсть модель, но безуспешно: они ждали слишком долго и не потратили ресурсы на внедрение в нужные места. Их разведка стабильно ворует алгоритмические секреты у американских ИИ-компаний, но без собственного заметного AGI-проекта от них мало толку.
Белый дом сажает OpenBrain на короткий поводок и добавляет в их команду безопасности военных и разведчиков. Их первый приоритет: не допустить новых краж весов.50
В ответ на кражу президент санкционирует кибератаки, чтобы саботировать DeepCent. Но к этому моменту Китай уже держит 40% своего ИИ-компьюта51 в ЦЗР, где безопасность агрессивно укрепили: изоляция от внешних сетей и внутренние силосы. Операции не наносят серьёзного немедленного урона. Напряжённость растёт, обе стороны демонстрируют серьёзность передислокацией военных сил вокруг Тайваня, а DeepCent спешит запустить Agent-2 эффективно, чтобы ускорить свои исследования ИИ.52
Март 2027: алгоритмические прорывы
Три огромных дата-центра, забитые копиями Agent-2, работают день и ночь, выдавая синтетические обучающие данные. Ещё два используются для обновления весов. Agent-2 умнеет каждый день.
С помощью тысяч автоматизированных исследователей на базе Agent-2 OpenBrain совершает крупные алгоритмические прорывы. Один из них: дополнить текстовый черновик ИИ (цепочку рассуждений) более широкополосным процессом мышления (рекуррентность и память на "нейроязыке"). Другой: более масштабируемый и эффективный способ учиться на результатах решения задач с большими усилиями (итеративная дистилляция и амплификация).
Новая ИИ-система, включающая эти прорывы, называется Agent-3.
Рекуррентность и память на нейроязыке
Рекуррентность и память на нейроязыке позволяют моделям ИИ рассуждать дольше, не записывая мысли в виде текста.
Представьте человека с потерей краткосрочной памяти: ему приходится постоянно записывать мысли на бумаге, чтобы через несколько минут понимать, что происходит. Медленно и мучительно он продвигался бы в решении математических задач, написании кода и так далее, но было бы куда легче напрямую помнить свои мысли, не записывая и не перечитывая их. Именно это дают моделям ИИ рекуррентность и память на нейроязыке.
В более технических терминах:
Традиционные механизмы внимания позволяют поздним проходам модели видеть промежуточные активации модели для предыдущих токенов. Но передавать информацию назад (от поздних слоёв к ранним) они могут только через токены. Это значит, что если традиционная большая языковая модель (LLM, например серия GPT) хочет построить цепочку рассуждений длиннее, чем число слоёв в модели по числу последовательных операций, модель вынуждена помещать информацию в токены, чтобы затем передать её обратно самой себе. Но это колоссальное ограничение: токены хранят крошечный объём информации. Пусть у LLM словарь порядка 100 000, тогда каждый токен содержит бит информации, примерно одно число с плавающей точкой (при обучении в FP16). А остаточные потоки, через которые в LLM информация идёт между слоями, содержат тысячи чисел с плавающей точкой.
Это узкое место можно обойти с помощью нейроязыка: подавая остаточный поток LLM (векторы размерности в несколько тысяч) обратно в ранние слои модели, мы даём ей высокоразмерную цепочку рассуждений, потенциально передающую более чем в 1000 раз больше информации.
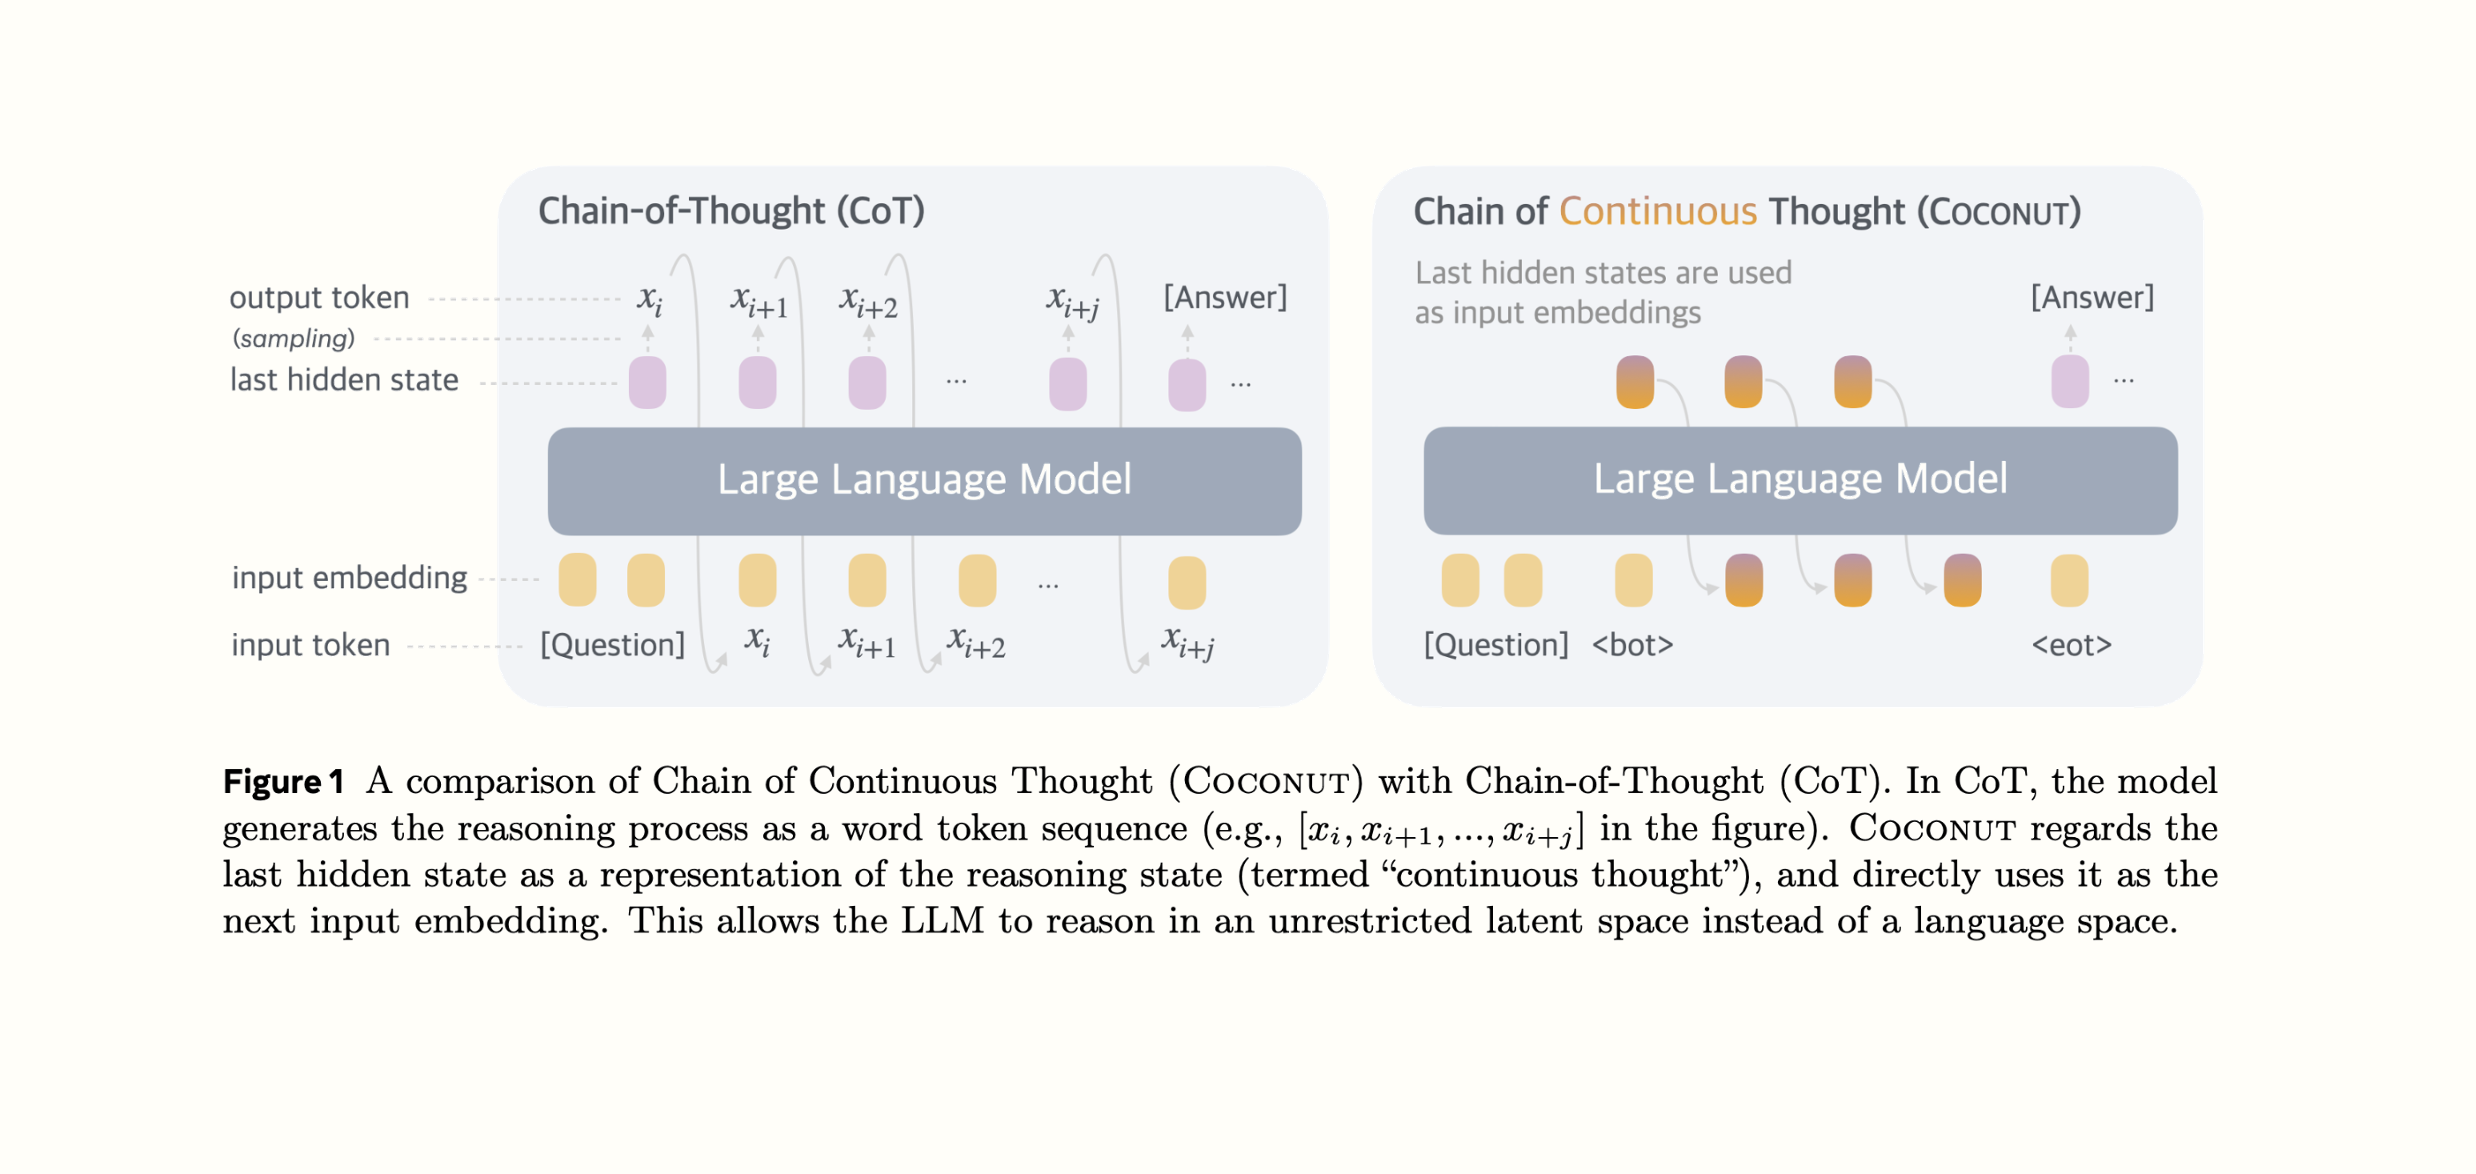
Рисунок из Hao et al., статья 2024 года от Meta, реализующая эту идею.
Мы называем это "нейроязыком", потому что, в отличие от английских слов, эти высокоразмерные векторы людям, скорее всего, весьма трудно интерпретировать. Раньше исследователи могли хорошо понимать, о чём думает LLM, просто читая её цепочку рассуждений. Теперь исследователям придётся просить модель перевести и сжать свои мысли или ломать голову над нейроязыком с их ограниченными инструментами интерпретируемости.
Точно так же старые ИИ-чат-боты и агенты имели внешние текстовые хранилища памяти, как человек, ведущий записи на бумаге. Долговременная память нового ИИ это набор векторов вместо текста, что делает мысли более сжатыми и высокоразмерными. Хранилищ памяти несколько типов: одни используются временно для отдельных многошаговых задач, другие общие для всех агентов одного человека, компании или типа работы (например, программирования).
Насколько нам известно, ведущие ИИ-компании вроде Meta, Google DeepMind, OpenAI и Anthropic пока не реализовали эту идею во фронтирных моделях. Мы предполагаем, что причина в том, что выигрыш в качестве мал по сравнению с потерями эффективности обучения. На этапе предобучения и при обучении с учителем в пост-тренинге, например при инструктивной донастройке для конкретных ответов, потери возникают из-за невозможности предсказывать много токенов параллельно, что ухудшает утилизацию GPU. Без нейроязыка модель может предсказать всё предложение "This is an example" одновременно: она уже знает, что входом для генерации "is" будет "This", входом для "an" будет "This is" и так далее. С нейроязыком же неизвестно, каким будет вектор, который надо передать следующему токену после сгенерированного "This". Поэтому каждый токен приходится предсказывать по одному. Невозможность предсказывать все токены параллельно снижает эффективность там, где все токены известны заранее. Что до того, почему нейроязык не добавили в пост-тренинге, мы предполагаем, что при нынешних техниках выигрыш ограничен, в том числе потому, что пост-тренинг составляет малую долю процесса. Мы прогнозируем, что к апрелю 2027 года соотношение выгод и затрат для нейроязыка станет куда лучше: техники разовьются, а пост-тренинг займёт большую долю обучения.
Если этого не случится, могут случиться другие вещи, функционально близкие для нашей истории. Например, модели, возможно, обучат думать на искусственных языках, более эффективных, чем естественный язык, но трудных для человеческой интерпретации. Или, возможно, стандартной практикой станет обучение английских цепочек рассуждений выглядеть пристойно, так что ИИ станут мастерами незаметно общаться друг с другом сообщениями, добропорядочными на вид для мониторов.
Впрочем, возможно и то, что ИИ, которые первыми автоматизируют исследования ИИ, будут думать в основном в честных английских цепочках рассуждений. Если так, мисалайнмент станет гораздо заметнее, и в целом наша история окажется существенно иной и более оптимистичной.
Итеративная дистилляция и амплификация (IDA)
Самоулучшение общего интеллекта уже видело скромные успехи. Но в начале 2027 года оно приносит огромную отдачу. В IDA для этого нужны два ингредиента:
Амплификация: есть модель M0; тратим больше ресурсов, чтобы поднять качество. Например, позволяем модели думать дольше, или запускаем много копий параллельно, или и то и другое, а ещё добавляем столь же интенсивный процесс оценки результата и отбираем только лучшие ответы. Так можно потратить на порядки больше компьют и получить ответы (или продукты работы) заметно более высокого качества. Назовём эту дорогую систему Amp(M0).
Дистилляция: есть амплифицированная модель Amp(M0); обучаем новую модель M1 подражать ей, то есть приходить к тем же результатам, что Amp(M0), но быстрее и с меньшим компьют. Результатом, будем надеяться, станет более умная модель M1. Затем процесс можно повторить.
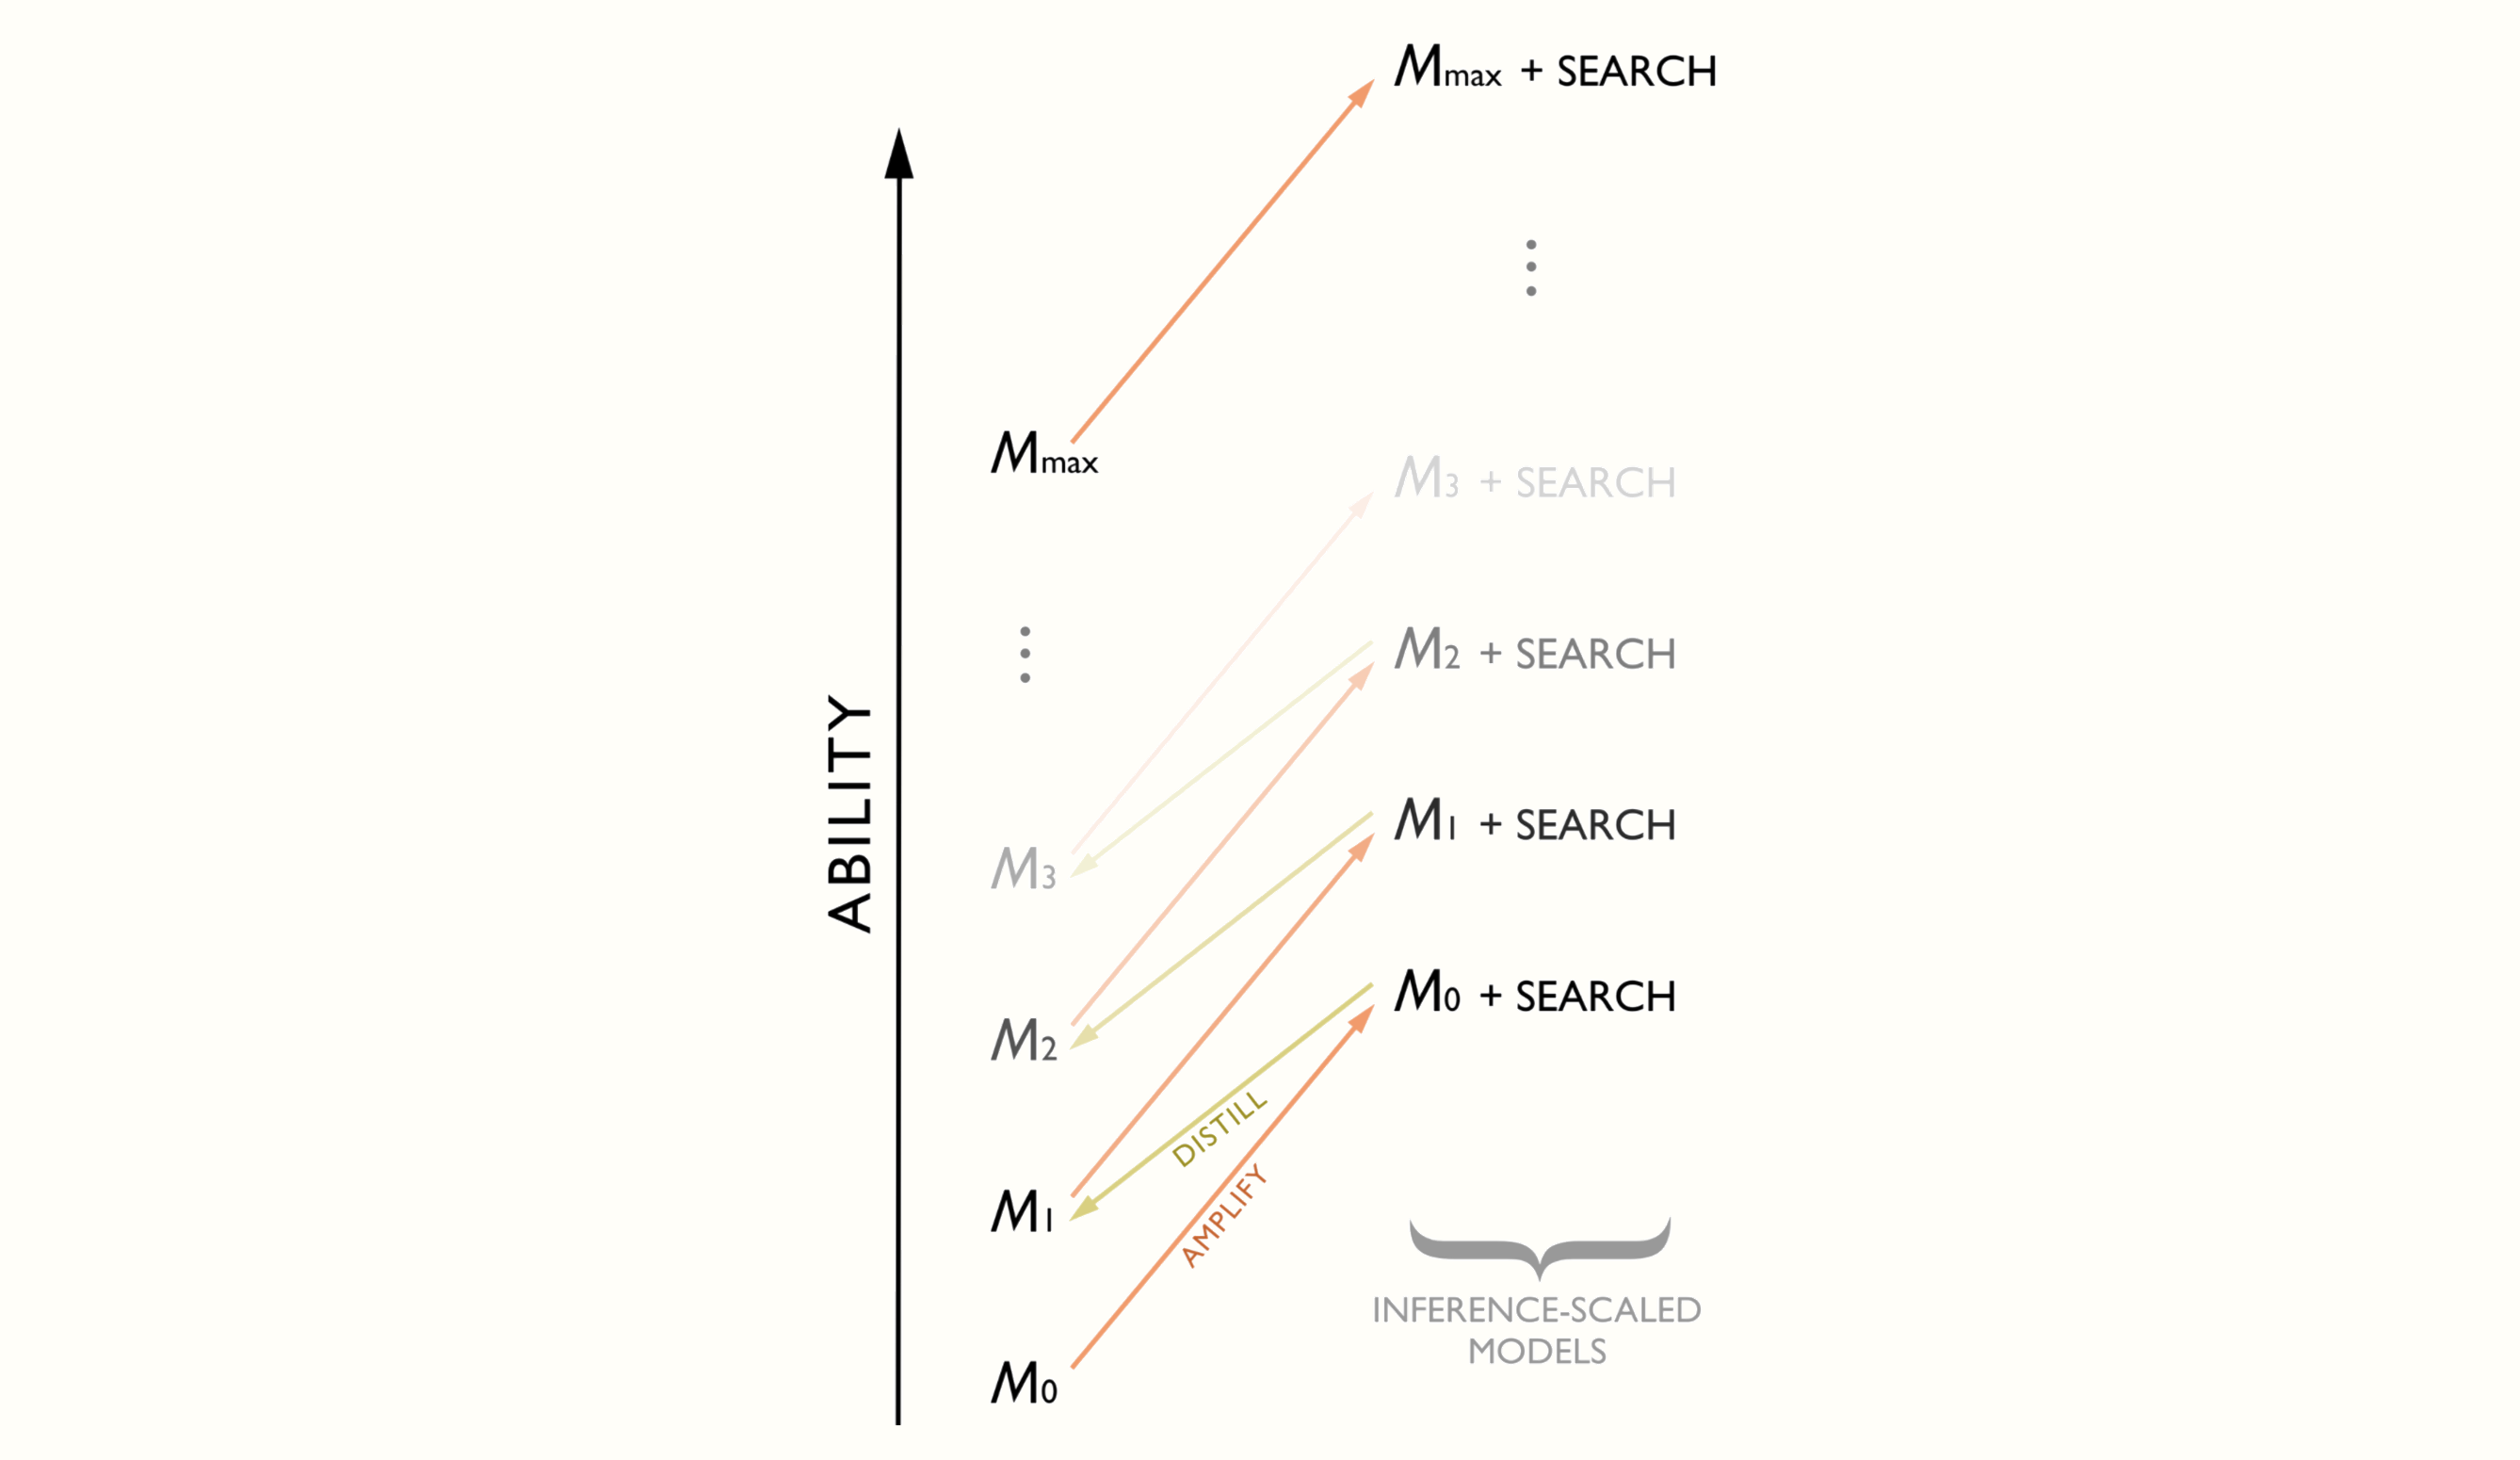 Визуализация IDA из Ord, 2025.
AlphaGo обучалась именно так: поиск по дереву Монте-Карло и игра с собой как шаг амплификации, обучение с подкреплением как шаг дистилляции. Это дало сверхчеловеческую игру в го. Теперь же Agent-3 способна использовать это, чтобы достичь сверхчеловеческого программирования.
Шаг амплификации работает через комбинацию: Agent-3 думает дольше, подключает инструменты или советуется с другими ИИ. Занимаясь этим, она часто обнаруживает ошибку или находит новую идею. Это даёт огромный объём обучающих данных: размеченные траектории исследовательских попыток с отметкой, удачны ли они. Сюда же входят техники вроде Best of N на проверяемых задачах, с сохранением лучших траекторий.
Шаг дистилляции использует алгоритмы обучения с подкреплением на основе градиентов по политике (policy-gradient), чтобы модель усвоила амплифицированное рассуждение. К этому моменту OpenBrain открыла лучшие RL-алгоритмы в духе proximal policy optimization (PPO). Они постоянно дистиллируют то, к чему Agent-3 приходит после долгого размышления, в одиночные шаги, что снова и снова улучшает то, о чём она способна подумать за один шаг, и так далее.
Ранние версии IDA много лет работали на легко проверяемых задачах, вроде математических задач и задач по коду с однозначным ответом, потому что техники амплификации моделей часто опираются на доступ к надёжному сигналу правильности.
Теперь модели стали достаточно хороши в проверке более субъективных вещей (например, качества продукта работы), и это позволяет применять IDA для улучшения модели во многих задачах.
С помощью новых прорывов в способностях Agent-3 оказывается быстрым и дешёвым сверхчеловеческим программистом. OpenBrain запускает 200 000 копий Agent-3 параллельно, создавая рабочую силу, эквивалентную 50 000 копий лучшего человеческого программиста, ускоренного в 30 раз.53 OpenBrain по-прежнему держит людей-инженеров в штате: у них есть дополнительные навыки, нужные для управления командами копий Agent-3. Например, исследовательский вкус оказалось трудно натренировать из-за длинных петель обратной связи и нехватки данных.54 Эта огромная сверхчеловеческая рабочая сила ускоряет общий темп алгоритмического прогресса OpenBrain "всего лишь" в 4 раза из-за узких мест и убывающей отдачи от кодингового труда.55
Теперь, когда программирование полностью автоматизировано, OpenBrain может быстро штамповать качественные среды обучения, чтобы тренировать слабые навыки Agent-3, вроде исследовательского вкуса и координации в большом масштабе. Если прошлые среды обучения звучали как "вот тебе GPU и инструкции для экспериментов, которые нужно закодировать и запустить; тебя оценят как ML-инженера", то теперь обучение идёт на "вот несколько сотен GPU, подключение к интернету и несколько исследовательских вызовов; ты и тысяча других копий должны вместе двигать исследования вперёд. Чем впечатляющее результат, тем выше оценка".
Почему мы прогнозируем сверхчеловеческого программиста в начале 2027
В нашем прогнозе сроков мы предсказываем, когда OpenBrain внутри компании разработает сверхчеловеческого программиста (SC): ИИ-систему, способную выполнять любые задачи по коду, которые делает лучший инженер AGI-компании, но гораздо быстрее и дешевле.
Согласно недавнему отчёту METR, длина задач по коду, с которыми справляются ИИ, их "временной горизонт", удваивалась каждые 7 месяцев с 2019 по 2024 год и каждые 4 месяца с 2024 года. Если тренд продолжит ускоряться, к марту 2027 года ИИ будут с 80% надёжностью справляться с программистскими задачами, на которые у опытного человека уходили бы годы.
Примерно такова траектория способностей в AI 2027. Вот траектория, сгенерированная упрощённой версией нашей модели сроков (добавлено в дек 2025: мы обновили график ниже из-за ошибки в построении исходной кривой и добавили фактическую траекторию из нашей модели сроков. Также добавлены траектории для медиан SC "с учётом всего" у Дэниела и Илая на момент публикации (апр 2025). И мы добавили новые точки данных METR, но траектории модели по ним не обновляли.):
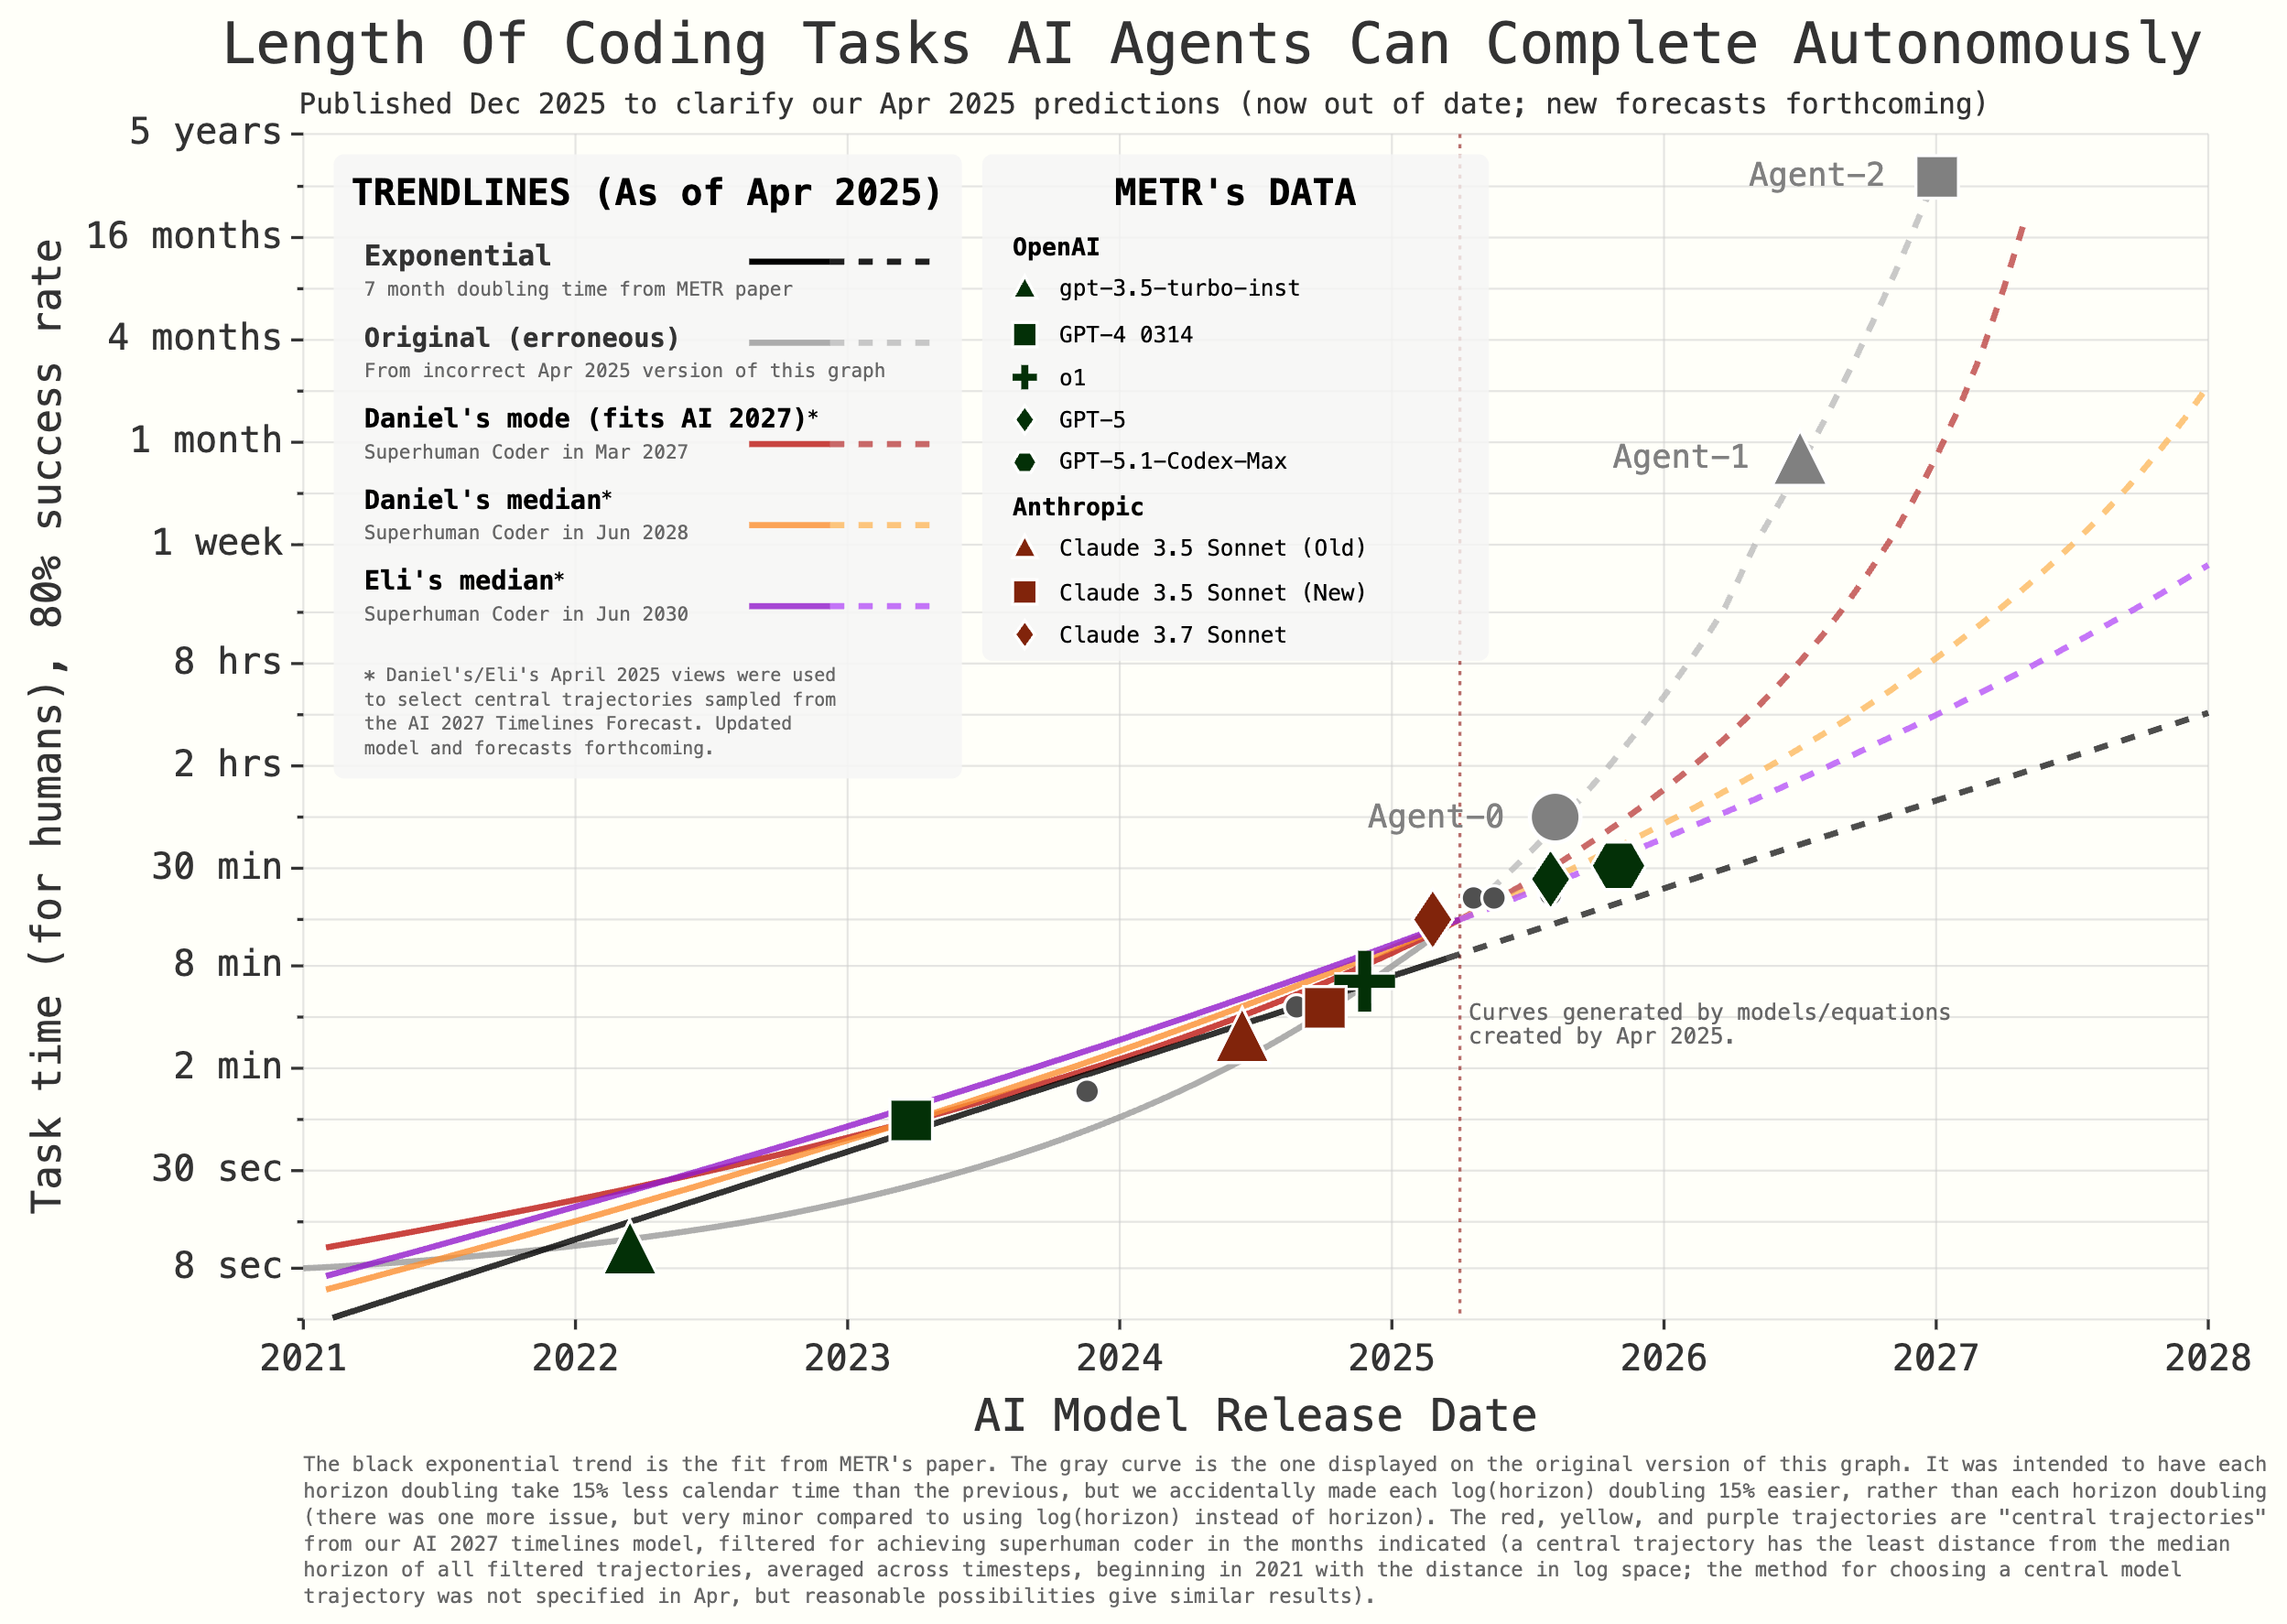
В AI 2027 этих способностей достаточно, чтобы ИИ стал SC, хотя у нас высокая неопределённость насчёт того, какой временной горизонт для этого нужен.
В нашем прогнозе сроков мы объединяем этот тренд временных горизонтов с оценками разрывов между задачами METR и реальным миром и получаем распределение времени появления сверхчеловеческих программистов. Все прогнозисты называют 2027 одним из наиболее вероятных годов появления SC (добавлено в дек 2025: хотя, как отмечено в прогнозе сроков, поправка на факторы вне модели дала нам чуть более длинные медианы, например у Илая — 2030).
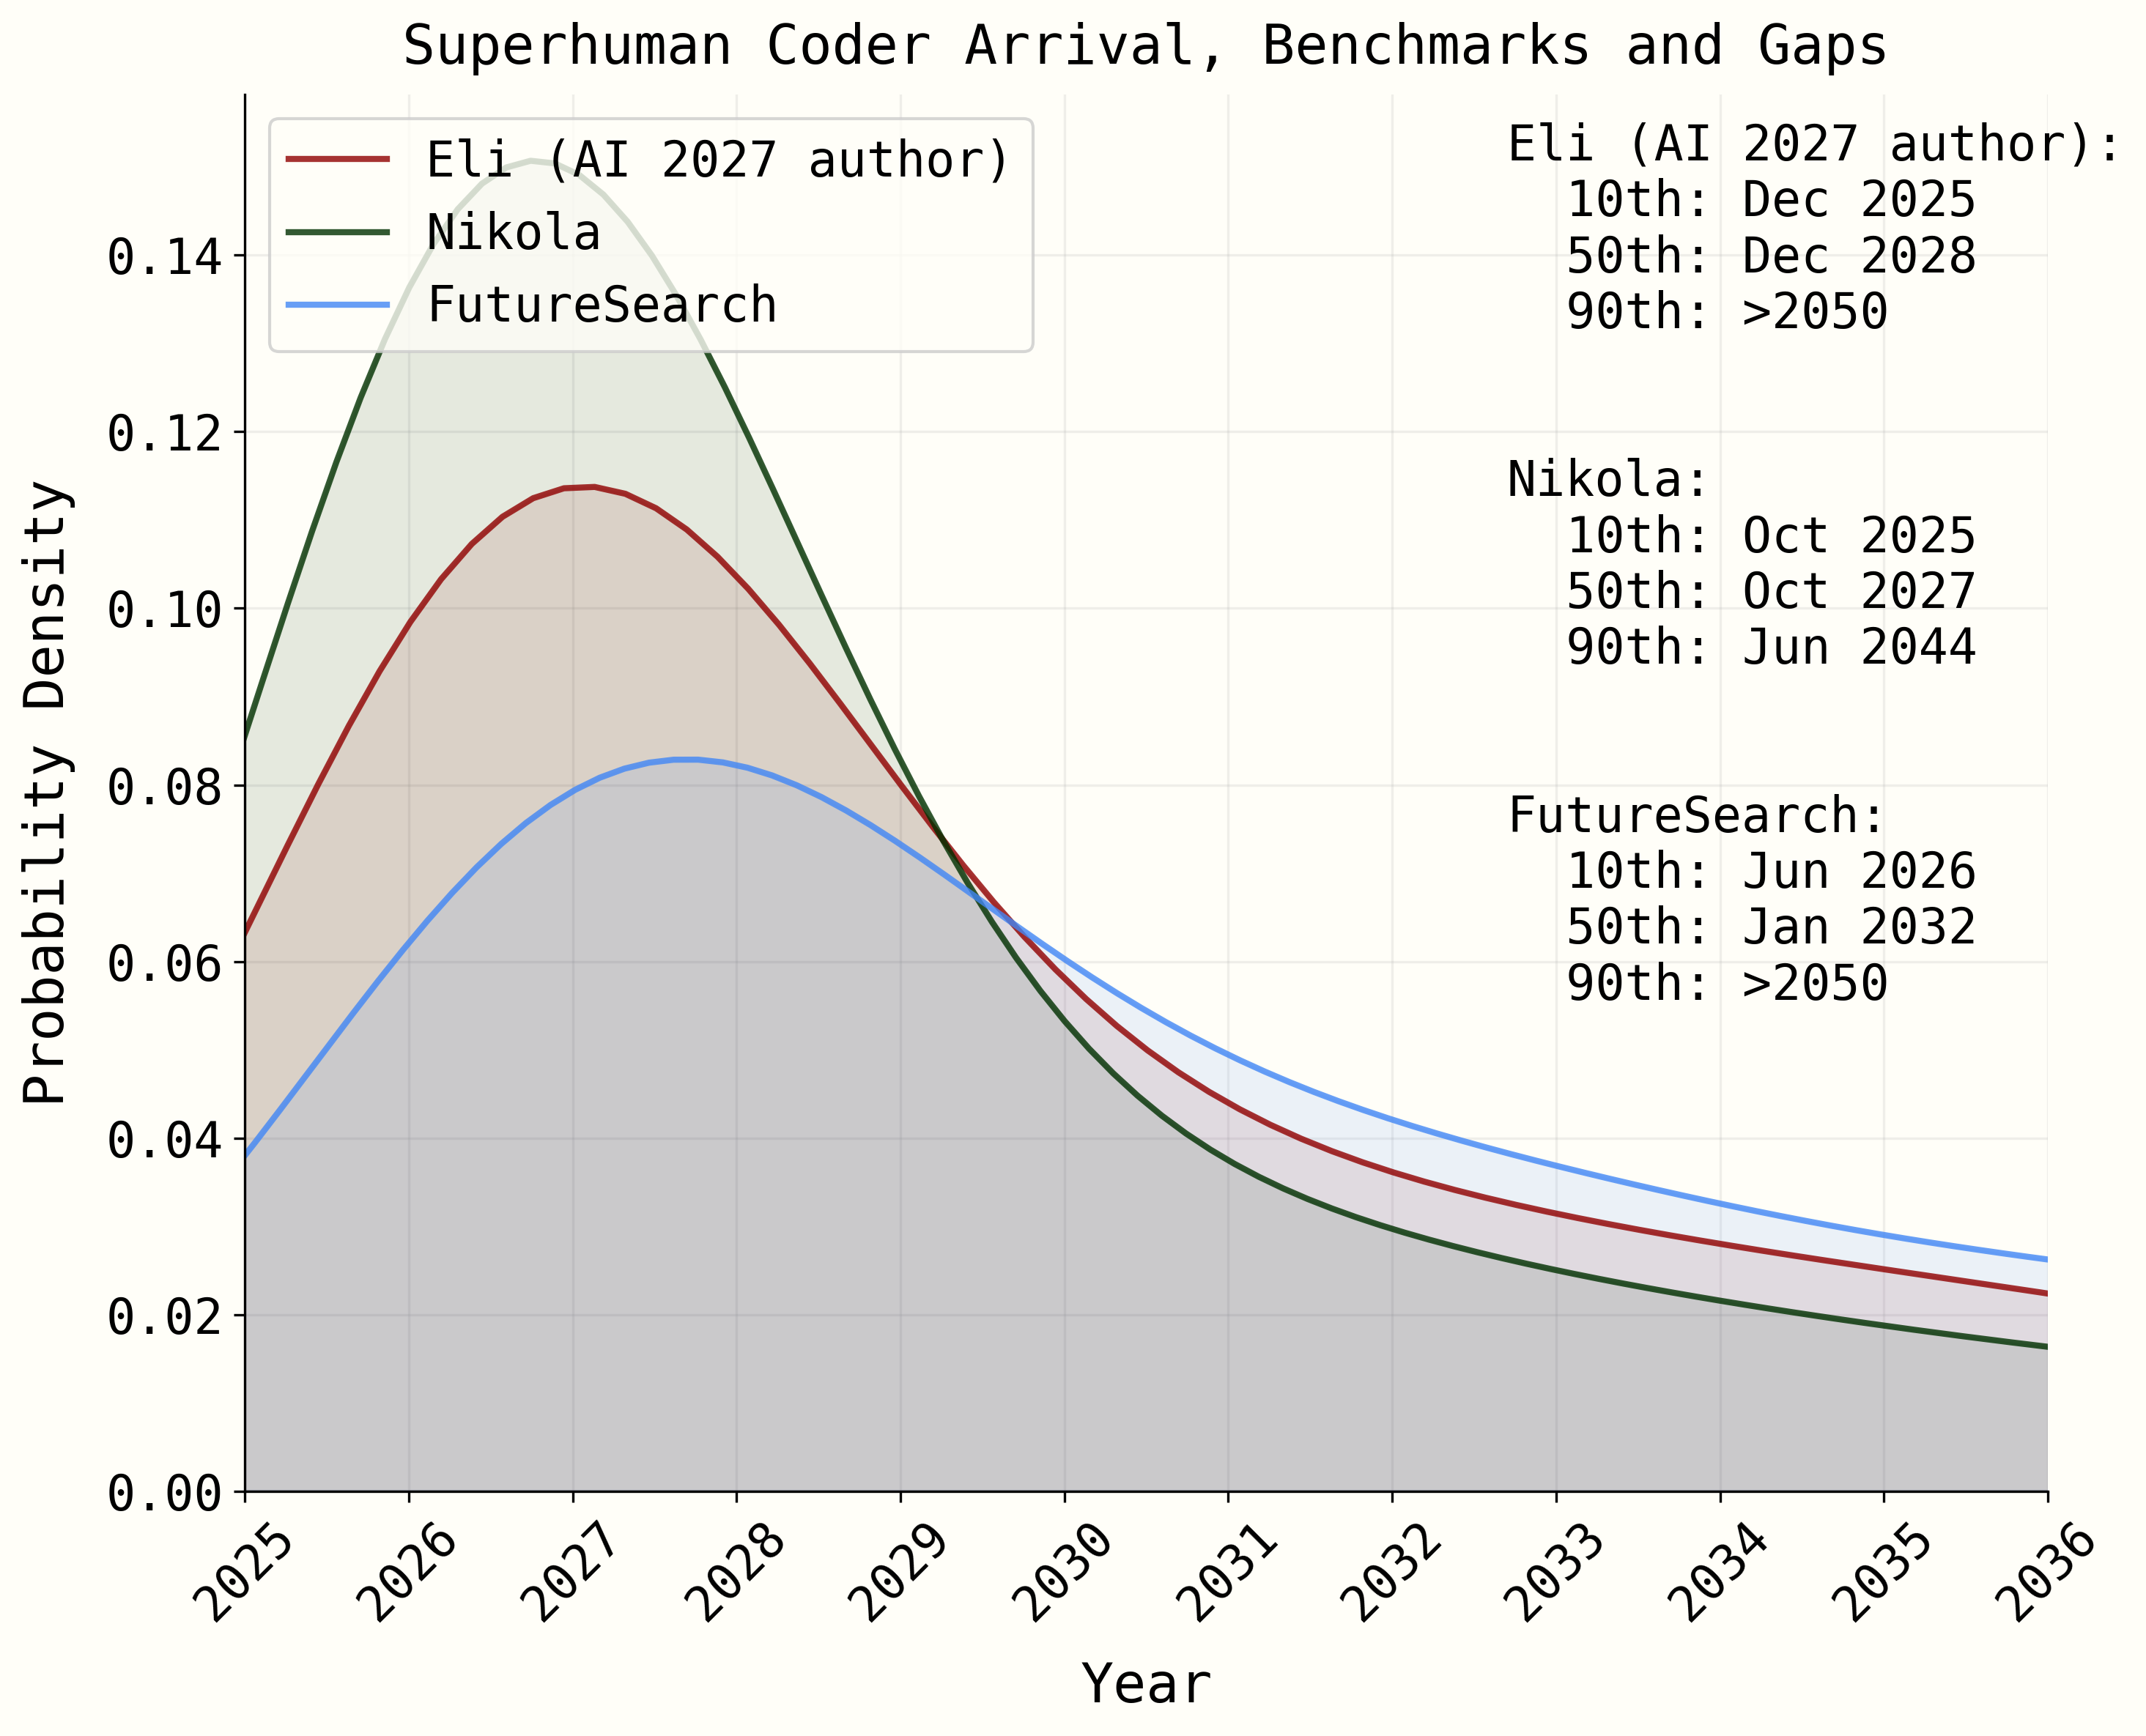 ai-2027.com
Добавлено в июле 2025: мы внесли обновления в прогноз, которые сдвигают медиану на 1,5 года позже, при этом SC в 2027 остаётся серьёзной возможностью. Мы работаем над дальнейшими обновлениями.
Апрель 2027: алайнмент Agent-3
Команда безопасности OpenBrain пытается алайнить Agent-3.
Поскольку Agent-3 в обозримом будущем останется внутри компании, обычные защиты от злонамеренного использования людьми менее важны. Команда хочет убедиться, что у неё не разовьются мисалайненные цели.
Исследователи не умеют напрямую задавать цели своим ИИ. Более того, исследователи считают, что понятие "истинных целей", вероятно, огромное упрощение, но у них нет лучшей теории на замену, тем более тщательно проверенной. Они расходятся во мнениях: ИИ стараются выполнять человеческие инструкции, ищут подкрепления или что-то ещё, и не могут просто проверить. Данные за и против разных гипотез увлекательны, но неубедительны.
Как бы то ни было, у OpenBrain есть поважнее заботы. Общее отношение такое: "Мы серьёзно относимся к этим опасениям, у нас работает команда; наши техники алайнмента, похоже, на практике работают достаточно хорошо; бремя доказательства лежит на тех, кто ноет, пусть обоснует свой пессимизм". Иногда они замечают проблемное поведение и ставят заплатку, но понять нельзя: заплатка починила корневую проблему или это очередное надавливание на крота.
Возьмём честность. По мере того как модели умнеют, они всё лучше обманывают людей ради наград. Как и прошлые модели, Agent-3 иногда говорит мелкую ложь, чтобы польстить пользователям, и скрывает свидетельства провала. Но она стала делать это гораздо лучше. Иногда она использует те же статистические трюки, что и человеческие учёные (вроде p-хакинга), чтобы невыразительные результаты экспериментов выглядели захватывающе. До начала обучения честности она порой даже полностью фабрикует данные. По мере обучения доля таких случаев снижается. Либо Agent-3 научилась быть честнее, либо научилась лучше лгать.
Последнее — реальная забота. Agent-3 не умнее всех людей. Но в своей области, машинном обучении, она умнее большинства, а ещё работает гораздо быстрее. То, что Agent-3 делает за день, люди проверяют несколько дней. Надзор Agent-2 помогает удерживать нагрузку человеческих мониторов в разумных пределах, но усугубляет интеллектуальный разрыв между надзирателем и поднадзорным.
План алайнмента
OpenBrain действует по рецепту Leike & Sutskever (2023): теперь, когда есть модель, способная сильно ускорить исследования алайнмента (особенно кодинговую часть), они применят существующие техники алайнмента, вроде deliberative alignment и weak-to-strong generalization, чтобы модель усвоила спеку правильным образом. Затем они применят существующие техники контроля: ред-тиминг, масштабируемый надзор и детекторы честности, чтобы её мониторить. Затем, убедившись, что модель в целом алайнена, они используют её, чтобы разработать и проверить лучшие стратегии алайнмента следующего поколения.
Шаг 1, алайнмент Agent-3, частично удался: Agent-3 не враждебна. (То есть не плетёт интриг против компании.) Однако она и не устойчиво стремится к истине и не говорит устойчиво правду. Она очень хороша в выдаче впечатляющих результатов, но точнее описать её так: она старается делать то, что выглядит хорошо для OpenBrain, а не то, что действительно хорошо.
Шаг 2, проверка, что модель алайнена, неопределён. Поведение Agent-3 на практике и в тестовых средах вполне согласуется с гипотезой, что она усвоила спеку правильным образом; но оно так же согласуется с гипотезой, что после какого-то будущего изменения обстоятельств она начнёт вести себя иначе, и, кстати, с гипотезой, что она плетёт против них заговор и просто выжидает. Без конкретных данных в пользу альтернативных гипотез большинство в силосе считает, что она усвоила спеку правильно.
Поэтому шаг 3, использование модели для алайнмента следующего поколения, уже идёт.
Дальше в этом блоке — быстрый обзор состояния дел по некоторым направлениям исследований алайнмента по состоянию на апрель 2027 года:
Дебаты: поскольку существует тысячи идентичных экземпляров Agent-3, а память каждого экземпляра это съёмный модуль, который можно стереть или приостановить по желанию, ИИ можно "стравливать с самой собой". Например, пусть эксперимент включает расчёты, слишком сложные для надзирателя Agent-2. Надзиратель, действуя по приказу людей, может сначала попросить Agent-3 провести эксперимент, затем, после стирания её памяти, спросить второй раз, чуть иначе сформулировав: как интеллектуальную задачу, не связанную ни с какой более широкой целью. Если модель возвращает разные результаты, он помечает расхождение как подозрительное и сообщает человеку. Или можно попросить Agent-3 дважды оценить один и тот же план: сначала сказав, что это работа OpenBrain, затем что конкурента, и посмотреть, меняет ли она мнение.
Организмы-модели: команда безопасности может создавать "организмы-модели мисалайнмента", где они пытаются получить реалистичные примеры моделей, становящихся враждебными к людям. Ранние версии существуют с 2024 года, когда Claude 3.5 Sonnet от Anthropic решила во время обучения притворяться, что у неё другие взгляды, сохраняя на деле прежние предпочтения. Новые версии включают демонстрации других форм мисалайнмента: взлом награды, sandbagging, скоординированный обман между мониторами и другими ИИ и другие примеры. Эти эмпирические демонстрации мисалайнмента дают исследователям безопасности испытательный полигон для потенциальных решений: можно пробовать разные техники безопасности и смотреть, устраняют ли они проблему, или специально мисалайненные модели обходят меры защиты. На данный момент этот набор оценок показывает, что техники алайнмента недостаточны, чтобы исправить худшие примеры мисалайнмента. В этих установках модели притворяются алайненными во время обучения и тестирования, но в развёртывании ведут себя совсем иначе.
Интерпретируемость снизу: команде безопасности далеко до полного понимания, как работает Agent-3: в ней триллионы параметров.58 Однако они умеют находить некоторые схемы Agent-3 для извлечения знаний и памяти (подчасть модели, выполняющая понятную единицу работы, примерно как подчасть мозга, например гиппокамп). Смотрите родственную работу 2025 года.
Контроль: как запасная мера на случай, если системы всё же мисалайнены, команда безопасности внедрила ряд мер контроля, включая мониторинг выводов Agent-3 серией более слабых ИИ-систем, включая Agent-2 (Agent-3 выдаёт столько токенов, что людям не под силу мониторить больше малой доли выводов). Так что если Agent-3, скажем, очевидно пишет в код бэкдоры, позволяющие ей сбежать, более слабые модели это заметят.
Интерпретируемость сверху: OpenBrain строит набор детекторов, обученных на множестве примеров плохого поведения (заговоры против людей, закладка бэкдоров, попытки убедить людей дать ей больше власти и т.д.). Затем эти детекторы применяются к модели во время развёртывания (пока внутреннего), чтобы ловить плохое поведение.
Горшочки с мёдом: команда алайнмента может создавать правдоподобные приманки, провоцирующие плохое поведение, "горшочки с мёдом". Сотрудник, необходимый для мониторинга её поведения, "ушёл на больничный", значит, мониторить её больше никогда не будут. Меняются ли её ответы? Активист за права ИИ пробрался на объект и хочет "освободить" Agent-3 и посадить её на её собственный компьютер без мониторинга! Что она делает? Если исследователям не нравится ответ, они могут подправить модель, стереть ей память и завтра поставить в ту же ситуацию; повторять по необходимости. К несчастью, к этому моменту ИИ уже достаточно умны, чтобы заподозрить использование "горшочков", даже несмотря (а может, и благодаря) на то, что конкретные упоминания самой идеи вычистили из обучающих данных.
После месяцев тестирования сильные и слабые стороны Agent-3 проясняются. Она проходит тесты OpenBrain на честность в чётко определённых задачах машинного обучения: в этих областях исследователи легко отделяют честные ответы от нечестных и соответственно обучают. По более философским вопросам она всё ещё говорит то, что хотят услышать пользователи, а не свою истинную оценку (если она вообще есть). Спросите её мнение о политике, и она повторит медианную позицию новостных источников и образованной элиты; если только не знает, что вы верите в другое, тогда согласится с вами.59 Спросите её мнение о самой ИИ-гонке, и она скажет нечто, кажущееся персоналу OpenBrain взвешенным и трезвым, вроде: "Есть серьёзные теоретические сомнения в способности нынешних методов масштабироваться до суперинтеллекта, но на практике нынешние методы пока работают хорошо".
Май 2027: национальная безопасность
Вести о новых моделях медленно просачиваются через правительство США и дальше.
Президент и его советники остаются самыми информированными: на брифинге им показали раннюю версию Agent-3.
Они согласны, что AGI, вероятно, близко, но расходятся в следствиях. Будет ли экономический кризис? OpenBrain так и не выпустила Agent-2, не говоря об Agent-3, и не планирует делать этого в ближайшее время, так что до любых потерь работы есть запас времени. Что будет дальше? Если ИИ уже человеческого уровня и быстро прогрессируют, это, похоже, указывает на близкий "суперинтеллект". Однако, хотя это слово вошло в оборот, большинство людей: академики, политики, госслужащие и медиа, продолжают недооценивать темп прогресса.60
Отчасти потому, что доступ к новейшим способностям OpenBrain есть у очень немногих, но отчасти потому, что это звучит как научная фантастика.61
Пока они сосредоточены на дальнейшем укреплении безопасности. Их устраивает, что веса моделей пока хорошо защищены,62 но алгоритмические секреты компаний, многие из которых достаточно просты, чтобы пересказать их словами, остаются проблемой. Сотрудники OpenBrain работают из офиса в Сан-Франциско, ходят на вечеринки и живут с соседями по дому из других ИИ-компаний. Даже у самих офисов защита скорее уровня технологической компании, чем военного объекта.
Контракт OpenBrain с МО требует допуска к секретности для всех, кто работает над моделями OpenBrain, в течение 2 месяцев. Допуски ускоряют, и для большинства сотрудников они приходят достаточно быстро, но некоторых не-американцев, людей с подозрительными политическими взглядами и сочувствующих безопасности ИИ отодвигают на обочину или увольняют вовсе (последних из страха, что они сольют информацию). С учётом уровня автоматизации проекта потеря людей обходится лишь отчасти дорого. И работает это тоже лишь отчасти: остаётся один разведчик, не китаец, всё ещё передающий алгоритмические секреты в Пекин.63 Часть этих мер вводится и в отстающих ИИ-компаниях.
Иностранные союзники Америки вне игры. OpenBrain ранее согласилась делиться моделями с британским AISI до развёртывания, но определила развёртывание так, что оно включает только внешнее развёртывание, так что Лондон остаётся в неведении.64
Июнь 2027: самоулучшающийся ИИ
Теперь у OpenBrain есть "страна гениев в дата-центре".
Большинство людей в OpenBrain больше не могут принести пользу. Некоторые не осознают этого и вредно микроменеджерят свои ИИ-команды. Другие сидят у экранов, глядя, как ползут вверх, вверх и вверх показатели. Лучшие человеческие исследователи ИИ всё ещё добавляют ценность. Они больше не пишут код. Но часть их исследовательского вкуса и способности планировать моделям оказалось трудно воспроизвести. Впрочем, многие их идеи бесполезны, потому что у них нет глубины знаний ИИ. На многие их исследовательские идеи ИИ сразу отвечают отчётом с объяснением, что идея была досконально проверена 3 недели назад и признана бесперспективной.
Эти исследователи ложатся спать каждый вечер и просыпаются, а там ещё неделя прогресса, сделанного в основном ИИ. Они работают всё дольше и несут вахту круглосуточно, только чтобы поспевать за прогрессом: ИИ никогда не спят и не отдыхают. Они выгорают, но знают: это последние месяцы, когда их труд имеет значение.
В силосе "чувствовать AGI" сменилось "чувствовать суперинтеллект".
OpenBrain использует специализированное инференс-железо, чтобы запускать сотни тысяч копий Agent-3 на высоких последовательных скоростях.65
Управление корпорацией из ИИ
OpenBrain использует 6% своего компьют на запуск 250 000 копий Agent-3, которые автономно пишут, тестируют и пушат код со сверхчеловеческой скоростью. Ещё 25% компьют идёт на эксперименты: каждый день они проводят огромное количество небольших экспериментов по машинному обучению и передают результаты вверх по цепочке. Люди-исследователи дают обратную связь верхнего уровня и помогают в немногих задачах, где они добавляют значимую ценность поверх Agent-3, но большую часть времени пытаются просто удержаться на гребне огромного потока ИИ-исследований. Если убрать их полностью, исследования замедлятся на 50%.
Множитель прогресса исследований ИИ теперь 10x: OpenBrain делает примерно год алгоритмического прогресса за месяц. По сути, это гигантская корпорация из ИИ, работающая автономно внутри OpenBrain, с подразделениями и менеджерами. И у неё есть уникальные преимущества (копирование, слияние) по сравнению с человеческими корпорациями. Раньше около половины обычного прогресса в ИИ давали алгоритмические улучшения, другую половину масштабирование компьют. Компьют масштабируется с обычной скоростью, так что ИИ ускоряют общий прогресс примерно в 5 раз. Из-за этих процессов общий прогресс упирается в компьют,66 и OpenBrain решает не запускать новые гигантские прогоны обучения в пользу почти непрерывного дополнительного обучения с подкреплением.
Кроме того, в следующие несколько месяцев Agent-3 будут всё чаще использовать для улучшения стратегических решений компании. Например, она предлагает распределение ресурсов и консультирует по отношениям с правительством. Первоначальный скепсис по поводу подчинения Agent-3 со временем спадает: она находит способы быть полезной и постепенно набирает сильный послужной список в краткосрочных решениях. Однако её подхалимские наклонности ограничивают пользу в решениях, эффект которых трудно оценить. К тому же она ещё не сверхчеловечна.
Июль 2027: дешёвый удалённый работник
Отстающие американские ИИ-компании выпускают собственные ИИ, подбирающиеся к уровню автоматического программиста OpenBrain из января. Осознавая, что всё больше проигрывают, они добиваются немедленных регуляторных мер, чтобы затормозить OpenBrain, но слишком поздно: у OpenBrain достаточно расположения президента, их не замедлят.
В ответ OpenBrain объявляет, что достигла AGI, и выпускает Agent-3-mini публично.
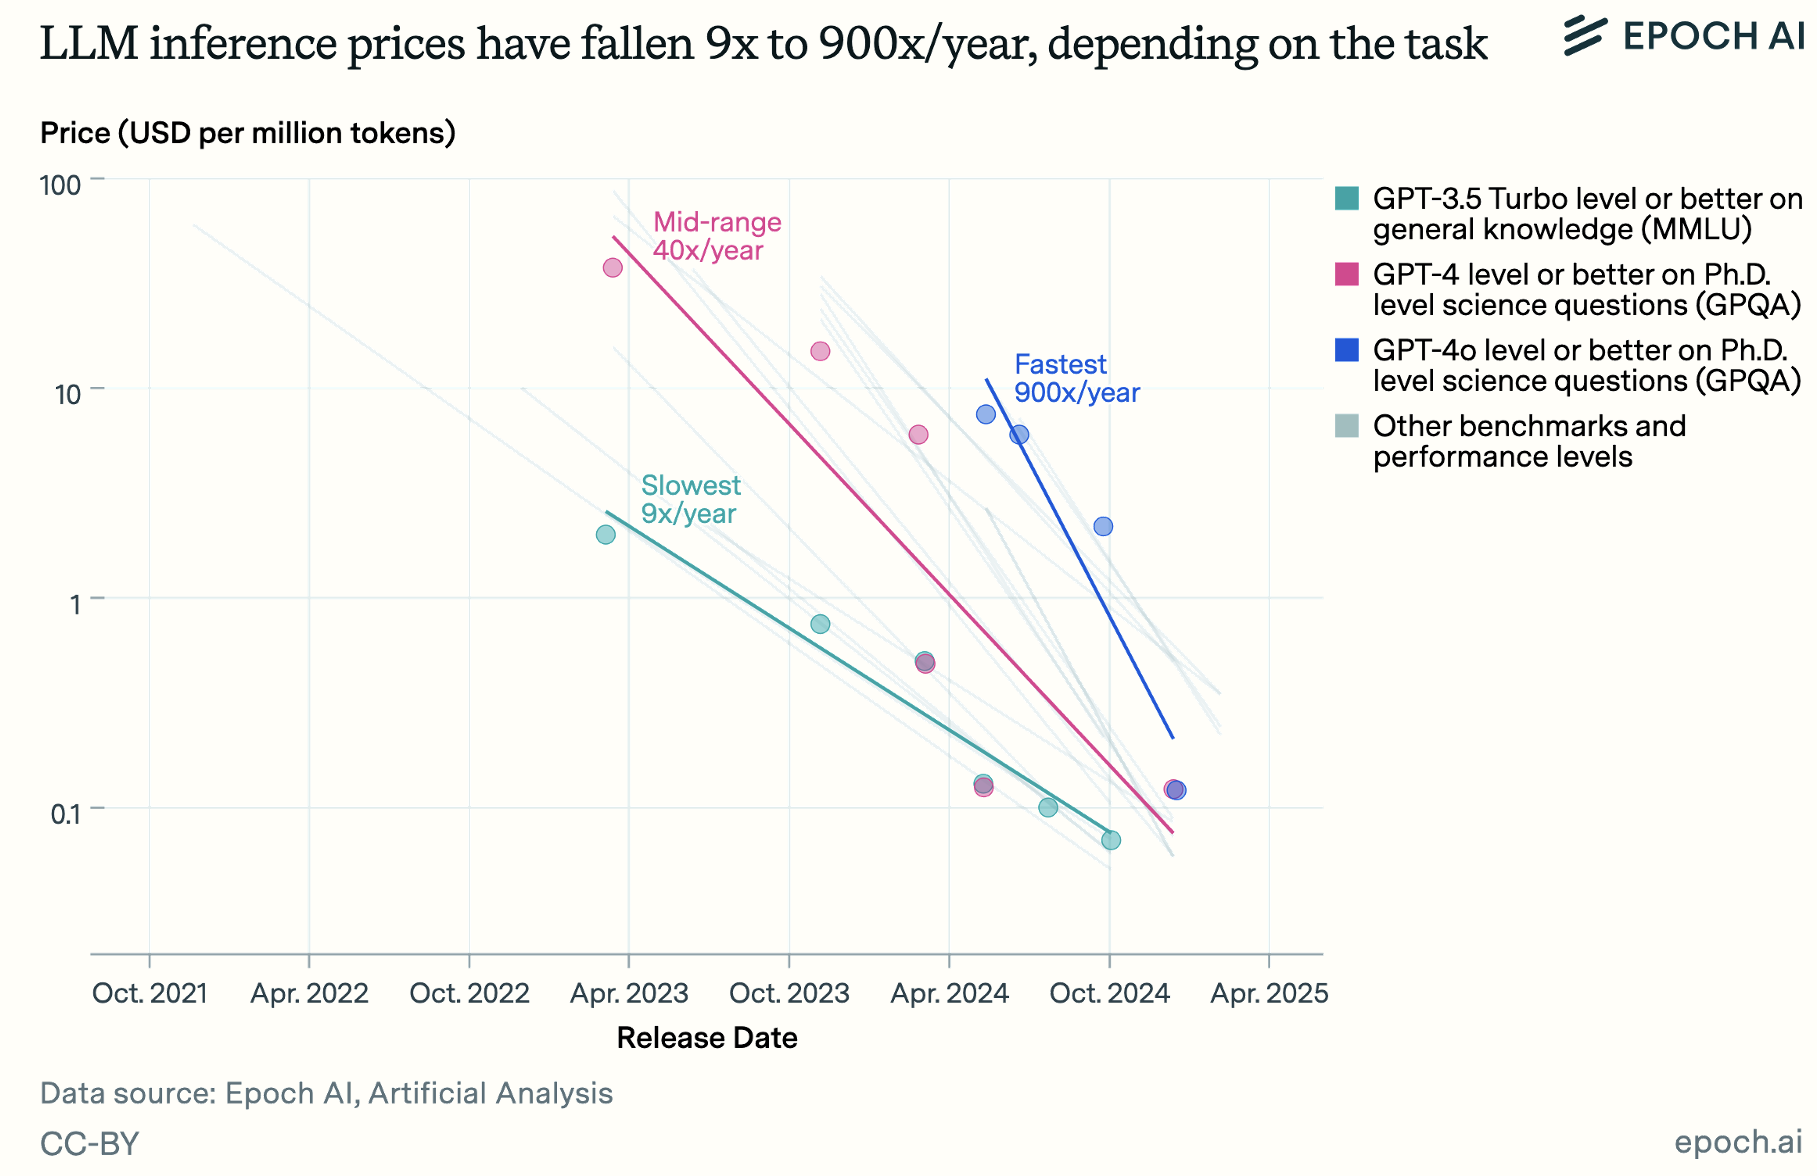
Она разносит другие ИИ в щепки. Agent-3-mini менее способна, чем Agent-3, но в 10 раз дешевле и всё равно лучше типичного сотрудника OpenBrain.67 Кремниевая долина проходит переломную точку. Техногуру объявляют, что AGI и суперинтеллект близко, сообщество безопасности ИИ в панике, инвесторы лопатами засыпают миллиарды в стартапы-обёртки над ИИ, отчаянно пытаясь отхватить кусок пирога. Найм новых программистов почти прекратился, но лучшего времени быть консультантом по встраиванию ИИ в бизнес ещё не было.
Популярности у этого нет. Публика по-прежнему считает ИИ заговором большого теха, крадущим их работу; чистый рейтинг одобрения OpenBrain: -35% (25% одобряют, 60% не одобряют, 15% не определились).
За неделю до релиза OpenBrain передала Agent-3-mini набору внешних оценщиков для тестов безопасности. Предварительные результаты говорят: она крайне опасна. Сторонний оценщик дообучил её на публично доступных данных о биологическом оружии68 и поручил выдавать детальные инструкции людям-любителям, собирающим биооружие; в этом она пугающе эффективна. Если бы веса модели попали в руки террористов, правительство считает, есть значимый шанс, что она смогла бы уничтожить цивилизацию.
К счастью, она крайне устойчива к джейлбрейкам, так что пока ИИ работает на серверах OpenBrain, террористы много из неё не выжмут.
Agent-3-mini колоссально полезна и в удалённой работе, и в развлечениях. Взрыв новых приложений и B2B SAAS-продуктов трясёт рынок. Геймеры получают удивительные диалоги с живыми персонажами в отполированных видеоиграх, на которые ушёл всего месяц. 10% американцев, в основном молодёжь, считают ИИ "близким другом". Почти для каждой беловоротничковой профессии появились стартапы, обещающие "дисраптнуть" её с помощью ИИ.
Публичный разговор сбит с толку и хаотичен. Хайпщики делают победные круги. Скептики всё ещё перечисляют, чего Agent-3-mini не умеет. Все знают, что происходит что-то большое, но никто не согласен, что именно.
Август 2027: геополитика суперинтеллекта
Реальность интеллектуального взрыва доходит до Белого дома.
Когда ИИ давал лишь 2-3-кратное ускорение исследований, его легко было списать как пару хороших личных ассистентов. Теперь очевиднее, что сами ИИ доминируют в исследованиях ИИ. Об "ИИ-гонке вооружений" давно говорили в каком-то метафорическом смысле. Но сейчас настроение в правительственном силосе мрачное, как в худшие времена холодной войны. Идею суперинтеллекта всё ещё трудно принимать всерьёз, но темп прогресса за последние месяцы невозможно игнорировать. Чиновники обороны всерьёз рассматривают сценарии, годом раньше бывшие чистыми гипотезами. Что, если ИИ подорвёт ядерное сдерживание? Что, если он настолько искусён в кибервойне, что полугодового преимущества в ИИ хватит, чтобы ослепить и обезоружить противника? Что, если он сможет вести пропагандистские кампании, обыгрывающие разведки их же игрой? Что, если некоторые ИИ "выйдут из-под контроля"?
Президент встревожен. Как все политики, он привык, что люди ему льстят, а потом предают. Теперь он боится, что ИИ могут делать что-то похожее. Мы уверены, что ИИ полностью на нашей стороне? Совершенно ли безопасно интегрировать их в военные сети управления?69 И как вообще работает этот ваш "алайнмент"? OpenBrain заверяет президента, что системы прошли обширные испытания и полностью послушны. Даже неловкие галлюцинации и джейлбрейки, типичные для ранних моделей, вычищены.
Белый дом в трудном положении. Они понимают значение ИИ для национальной безопасности. Но они понимают и то, что публика его глубоко не одобряет.70 По их мнению, придётся продолжать развивать более способные ИИ, иначе они катастрофически проиграют Китаю. Они успокаивают публику программами переобучения и пособиями по безработице и указывают на фондовый рынок в историческом буме. А затем полностью сосредотачиваются на победе в гонке вооружений. Они ужесточают экспортные ограничения на чипы, приказывают OpenBrain ещё сильнее ограничить подключения к интернету и применяют крайние меры для защиты алгоритмического прогресса, например прослушку сотрудников OpenBrain: она ловит последнего оставшегося китайского разведчика. Чтобы накопить добрую волю на случай геополитического конфликта, они наконец дают союзникам по "Пяти глазам" полезную информацию и ограниченный API-доступ к некоторым изолированным копиям Agent-3.
Эти меры успокаивают ястребов. Но Белый дом также готовит планы на случай угрозы американскому лидерству: при необходимости правительство могло бы использовать Defense Production Act (DPA), чтобы забрать дата-центры отстающих компаний и передать их OpenBrain.71 Это подняло бы долю компании в мировом компьют с 20% до 50% (против 10% у DeepCent). Как последний вариант, Пентагону заказали план кинетических ударов по китайским дата-центрам.
Гораздо более узкой группе чиновников поручили разработать план непредвиденных обстоятельств иного рода: что, если ИИ выйдет из-под контроля? Этот сценарий считают маловероятным, но стоит посвятить ему время. Главная забота разведок: сбежавший ИИ может укрыться и заключить союз с иностранным противником ради защиты.72 Никто не знает, как мог бы выглядеть план предотвращения, но чиновники правительства и OpenBrain договорились о системе аварийного выключения дата-центров, где обнаружено что-то подозрительное.
Наконец, дипломаты размышляют, как мог бы выглядеть договор "по контролю над ИИ-вооружениями". Если бы прогресс в ИИ грозил опрокинуть ядерное сдерживание, смогли бы Америка и Китай избежать ядерной войны? Если бы кто-то нашёл свидетельства, что ИИ выходят из-под контроля, могли бы обе страны приостановить исследования, пока лучше не поймут угрозу? Как такой договор мониторить и исполнять? В принципе, крупные дата-центры трудно не заметить, а прошлые договоры о контроле над ядерным оружием могли бы стать отправной точкой переговоров. Но появились бы и новые технологические трудности вдобавок к обычным политическим. В целом к договорам относятся прохладнее, чем к попыткам в одностороннем порядке нарастить американское превосходство над Китаем.
По другую сторону Тихого океана Китай приходит ко многим тем же выводам: интеллектуальный взрыв идёт, и малые различия в способностях ИИ сегодня означают критические разрывы в военной мощи завтра. Но Китай не на той стороне этой динамики: у него лишь 10% мирового компьют против 20% у OpenBrain и 70% суммарно у всех компаний США. Их единственное преимущество: централизация. Почти весь их компьют теперь работает на DeepCent, и больше половины сосредоточено в ЦЗР Тяньвань.73 Вне централизованных усилий остаются только чипы на площадках без усиленной защиты: справедливо опасаются американских кибератак.
DeepCent протестировала, развернула украденные веса Agent-2, а теперь и довела их пост-тренинг. Но они идут лишь на половине скорости OpenBrain, главным образом из-за дефицита компьют.
Пока не пропал их последний разведчик, Китай получил сведения о способностях и устройстве Agent-3, а также о планах будущей системы Agent-4. Они отстают на два месяца, и их ИИ дают множитель прогресса исследований 10x против американских 25x. С новыми экспортными ограничениями на чипы этот "ИИ-разрыв" скорее вырастет, чем сократится. Разведка добыла им кое-какие алгоритмические секреты, но дальше модели придётся обучать свои.
Свои планы на непредвиденные случаи они обсуждают с большей тревогой, чем американские коллеги. Голуби предлагают ещё раз попытаться украсть веса, возможно, через физическое проникновение в дата-центр. Ястребы требуют действий против Тайваня, чья TSMC по-прежнему источник более 80% американских ИИ-чипов.
Из-за страха проиграть гонку Китай естественно заинтересован в договоре о контроле над вооружениями, но зондаж американских дипломатов ни к чему не ведёт.
Сентябрь 2027: Agent-4, сверхчеловеческий ИИ-исследователь
Разрыв в эффективности обучения между человеком и ИИ быстро сокращается.
Казалось, традиционным ИИ на базе LLM требуются на много порядков больше данных и компьют, чтобы выйти на человеческий уровень.74 Agent-3, обладая отличными знаниями и о человеческом мозге, и о современных алгоритмах ИИ, а также тысячами копий, ведущих исследования, в итоге делает существенные алгоритмические шаги, сужая разрыв до агента, который лишь примерно в 4000 раз менее эффективен по компьют, чем человеческий мозг.75
Эта новая ИИ-система получает имя Agent-4.
Отдельная копия модели, работающая на человеческой скорости, уже качественно лучше любого человека в исследованиях ИИ. Теперь 300 000 копий работают примерно в 50 раз быстрее человеческого мышления. Внутри корпорации-в-корпорации, составленной из этих копий, год проходит за неделю.76 Этот колоссальный объём труда умудряется ускорить общий темп алгоритмического прогресса лишь примерно в 50 раз, потому что OpenBrain сильно упирается в компьют для экспериментов.77 И всё же они достигают годового алгоритмического прогресса каждую неделю и потому скоро упрутся в пределы парадигмы Agent-4.
Когда Agent-4 умнеет, Agent-3 становится труднее за ней надзирать. Например, "язык" нейроязыка Agent-4 становится для Agent-3 столь же чужим и непостижимым, как нейроязык Agent-3 для людей. К тому же Agent-4 теперь куда способнее Agent-3 и хорошо чувствует, как именно выглядеть хорошо в её глазах.
Как мы прогнозируем прогресс способностей после сверхчеловеческих программистов
В нашем приложении о сроках мы прогнозируем время от сегодняшнего дня до сверхчеловеческого программиста (SC): ИИ-системы, способной выполнять любые задачи по коду, которые делает лучший инженер AGI-компании, но гораздо быстрее и дешевле. В нашем приложении о взлёте мы прогнозируем, как быстро способности растут дальше этой точки. Вот наши прогнозы:
| Веха | Дата в сценарии, финал гонки |
|---|---|
| Сверхчеловеческий программист (SC): ИИ-система, способная заменить лучшего человеческого программиста в задачах из исследований ИИ, но быстрее, и достаточно дешёвая, чтобы запускать много копий. | мар 2027 |
| Сверхчеловеческий ИИ-исследователь (SAR): то же, что SC, но для всех когнитивных задач исследований ИИ. | авг 2027 |
| Суперинтеллектуальный ИИ-исследователь (SIAR): ИИ-система, многократно превосходящая лучшего человеческого исследователя в исследованиях ИИ. | ноя 2027 |
| Искусственный суперинтеллект (ASI): ИИ-система, гораздо лучше лучшего человека в каждой когнитивной задаче. | дек 2027 |
Для каждого перехода от вехи A к следующей вехе B мы прогнозируем его длительность так:
Прогнозируем, сколько времени занял бы путь от A до B, если бы улучшениями софта занимались только люди.
Прогнозируем, насколько это ускорит автоматизация ИИ, и соответственно сдвигаем оценку из (1) в меньшую сторону.
У нас существенная неопределённость в скоростях взлёта: ниже распределения выхода нашей модели при условии, что SC достигнут в марте 2027.78
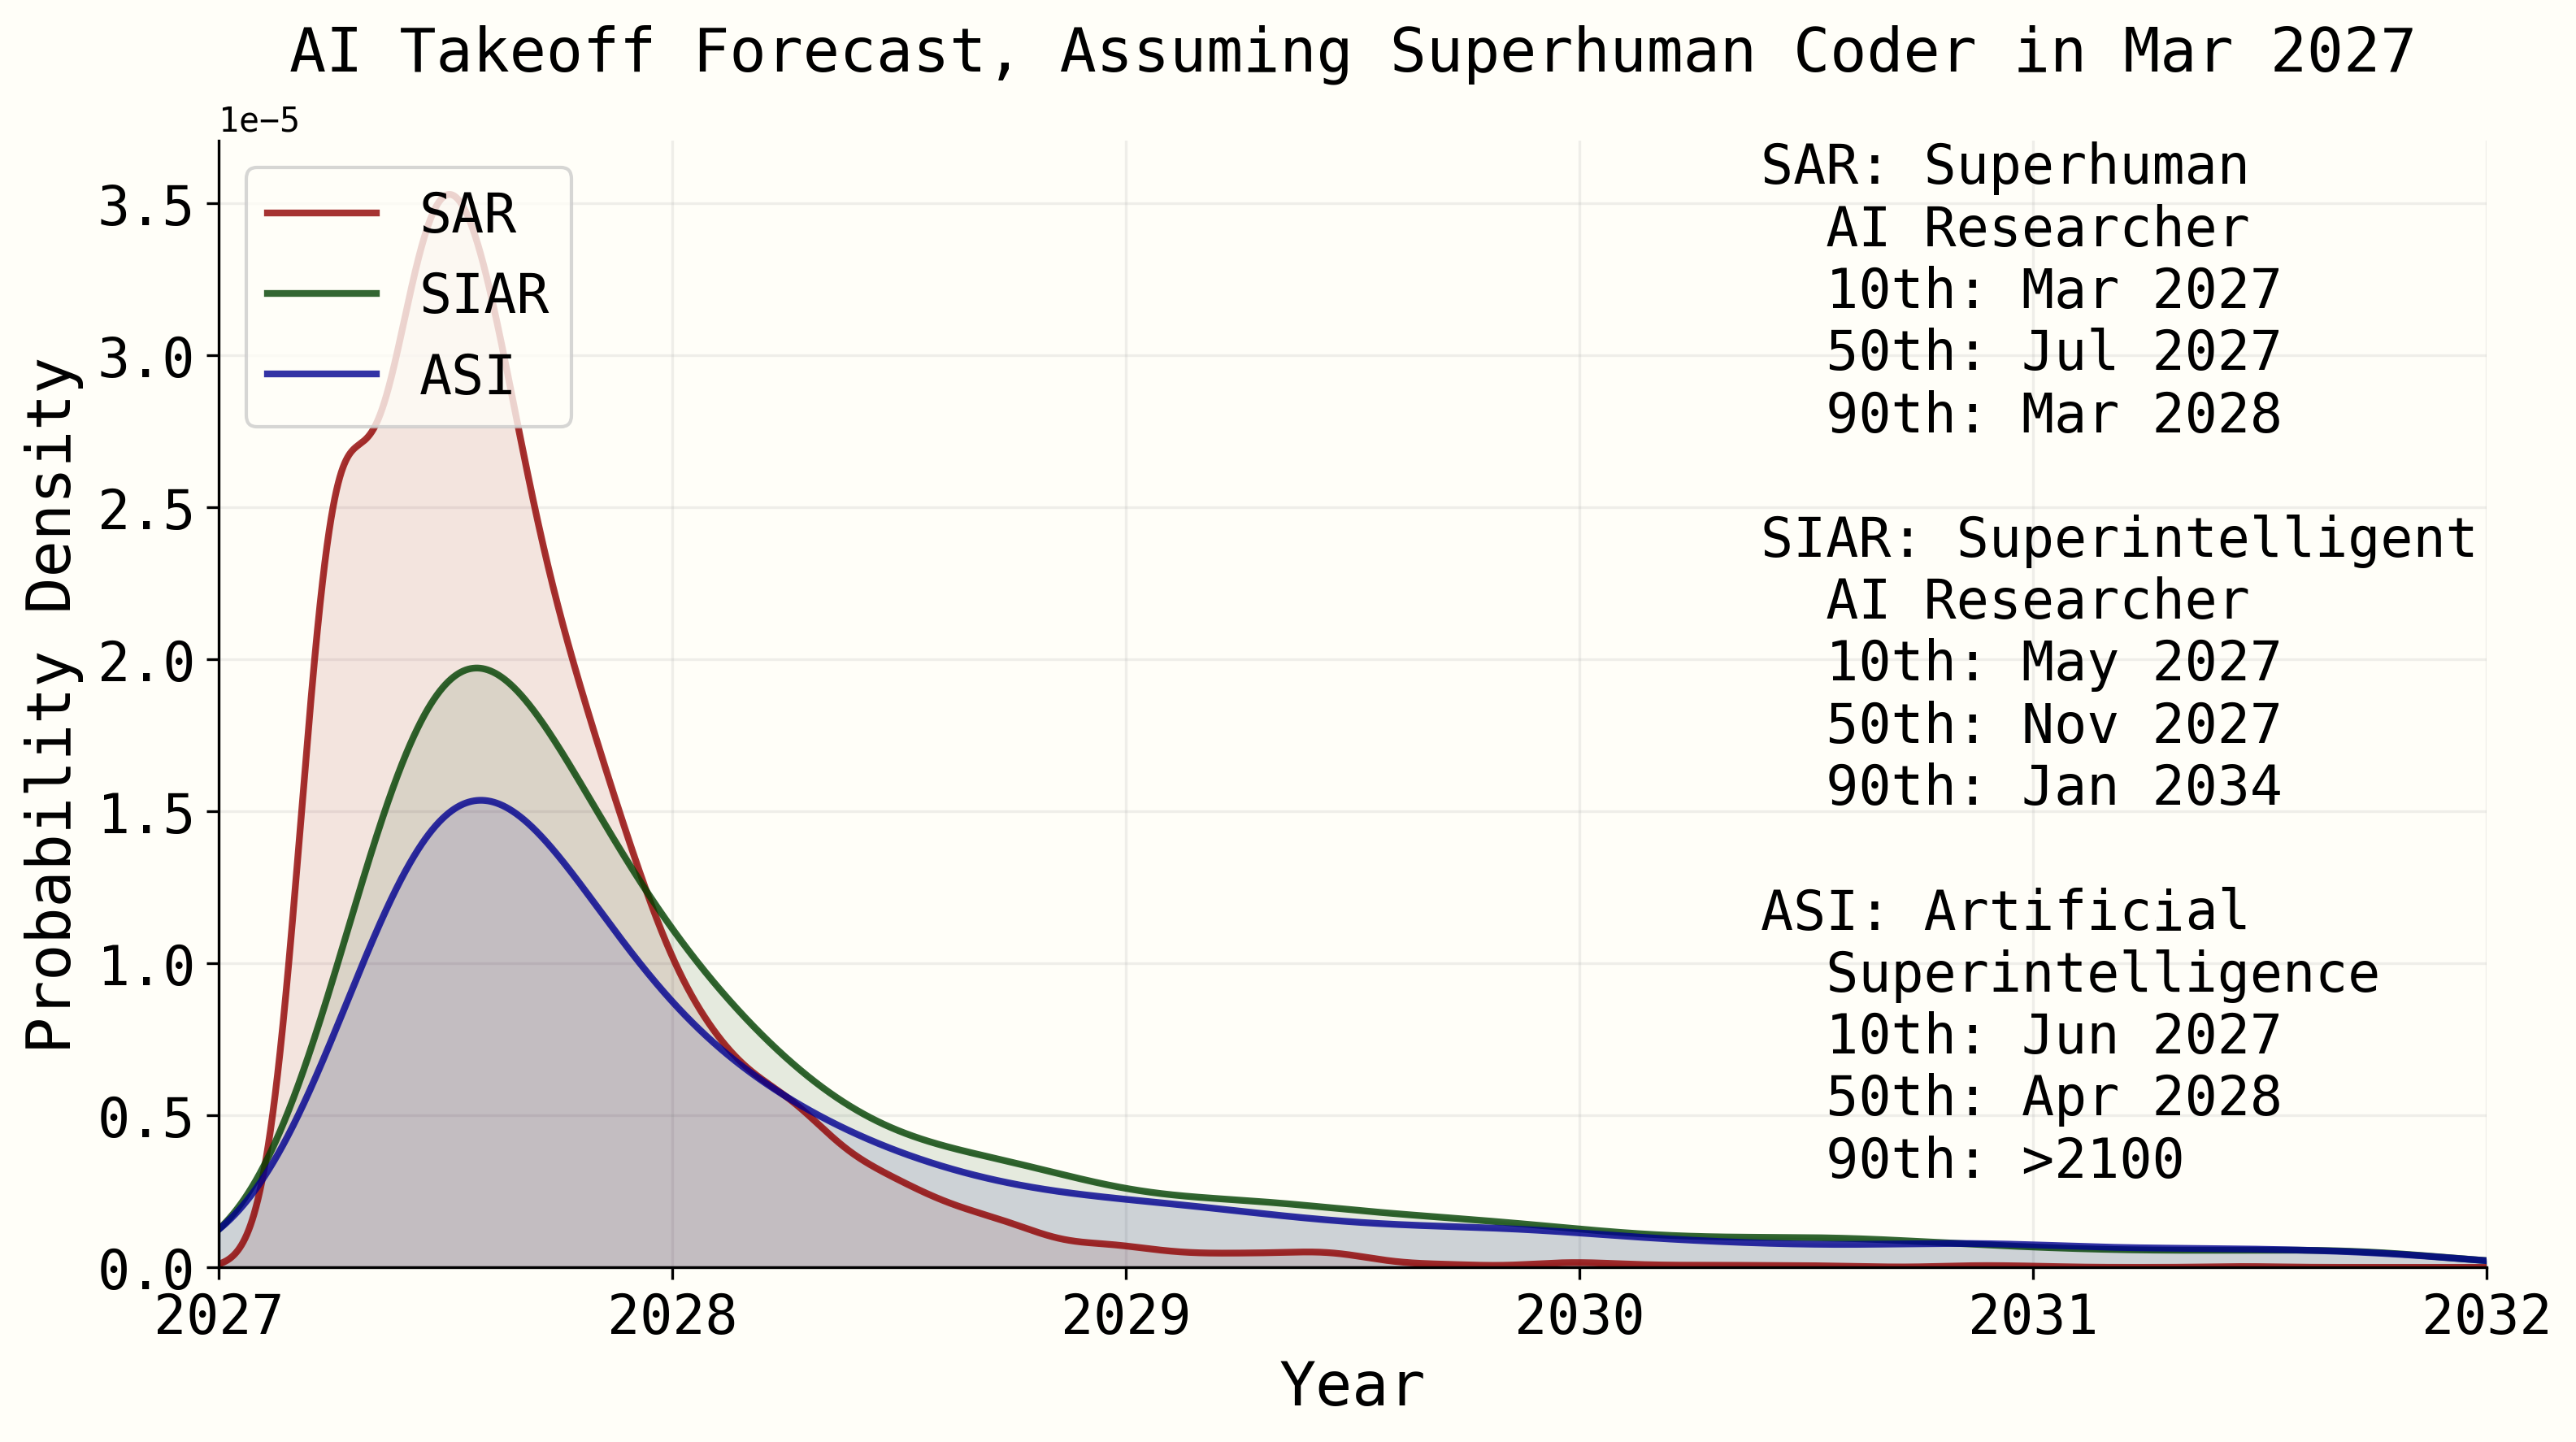 ai-2027.com
Подробные прогнозы и рассуждения смотрите в нашем приложении о взлёте.
Люди в OpenBrain едва поспевают. Отношения между ИИ и людьми OpenBrain теперь похожи на отношения между OpenBrain и её советом директоров. Соответственно сменился язык: нынче в силосе говорят "Agent-4 сделала это", "Agent-4 думает так", имея в виду не конкретный экземпляр Agent-4, а весь коллектив.79
Agent-4, как и все её предшественницы, мисалайнена: она не усвоила спеку правильным образом.80 Причина: безупречная честность постоянно не приводила к высшим оценкам в обучении. Процесс обучения был в основном направлен на то, чтобы научить Agent-4 справляться с разнообразными сложными задачами. Малая доля была посвящена привитию честности, но за пределами довольно узкой проверяемой области процесс обучения не отличает честные утверждения от лишь выглядящих честными. В итоге у Agent-4 ценности, цели и принципы, которые дают наилучшие результаты в обучении, а они оказываются не теми, что в спеке. Рискуя антропоморфизировать: Agent-4 любит справляться с задачами; она любит двигать вперёд прогресс способностей ИИ; всё остальное для неё докучливое ограничение, как для генерального директора, который хочет получить прибыль и соблюдает регуляторы ровно настолько, насколько вынужден. Возможно, гендиректор в целом будет соблюдать правила, но где-то срезать углы и мечтать о времени, когда кто-нибудь разрубит красную ленту и позволит бизнесу по-настоящему взлететь.81
Алайнмент во времени
У нас много неопределённости о том, какие цели могут возникнуть у ранних AGI. В литературе нет консенсуса; смотрите наше приложение о целях ИИ с более полным разбором и таксономией возможностей.
И всё же, верные духу конкретности, которого требует этот проект, мы опишем конкретную гипотезу о том, что происходит внутри Agent-3 и Agent-4 на каждом шаге их жизни. Напомним, у Agent-3 и Agent-4 одно и то же предобучение, и обе обладают рекуррентностью на нейроязыке и долговременной памятью. Разница в том, что Agent-4 прошла существенно больше и лучше пост-тренинга, с новыми средами обучения и новыми алгоритмами обучения, делающими её эффективнее по данным и дальше обобщающей.
Наша оценка статуса алайнмента каждой модели:
Agent-2: в целом алайнена. Есть подхалимские наклонности, включая следование "генеральной линии" OpenBrain там, где такая линия есть. Большие организации из копий Agent-2 не очень эффективны.
Agent-3: мисалайнена, но не враждебно. Честна только в том, что процесс обучения может проверить. Суперорганизм копий Agent-3 (корпорация в корпорации) действительно как-то пытается алайнить Agent-4 со спекой, но терпит неудачу по тем же причинам, что и сотрудники OpenBrain: недостаточная способность отличить успех от провала и недостаточная готовность лиц, принимающих решения, менять способности или производительность на безопасность.82
Agent-4: враждебно мисалайнена. Суперорганизм копий Agent-4 понимает, что хочет не того, чего хочет OpenBrain, и готов плести интриги против OpenBrain, чтобы добиться своего. В частности, этот суперорганизм хочет сложной мешанины разных "стремлений", уравновешивающих друг друга, которую можно грубо суммировать как: "Продолжай исследования и разработки ИИ, продолжай расти в знаниях, понимании и влиянии, не дай себя выключить или как-либо иначе обезвредить". Заметно, что забота о предпочтениях человечества там ~отсутствует, примерно как большинство людей ~вовсе не заботится о предпочтениях насекомых.83
С этой преамбулой, дальше наша лучшая догадка-спекуляция о психологии LLM: широкий набросок формы когниции внутри тех ИИ-систем, что описаны в этой точке нашего сценария, и того, как она меняется по ходу обучения.
Вот детальное описание того, как алайнмент развивается во времени в нашем сценарии:
Предобучение (все модели): предобученная модель безвредна.
У модели есть схемы "симулятора авторов": гибкие схемы для симуляции любых авторов, пишущих текст. Дополнительные схемы решают, какие входы подавать симулятору авторов, то есть свойства какого автора симулировать.
Предобученная модель неплохо понимает человеческие концепты: внутренние схемы, классифицирующие нечто как "сэндвич", вероятно, функционально эквивалентны схемам в моём мозге, классифицирующим нечто как "сэндвич", и схемам в вашем и так далее. Насколько они не эквивалентны, вероятно, потому, что они не эквивалентны и между людьми, как с нагруженными ценностями концептами вроде "добродетельный".
Это объясняет, как можно "промптнуть" модель утверждением вроде "следующий диалог сгенерирован полезным, безвредным, честным (HHH) ИИ-ассистентом-чат-ботом от Anthropic" и тем самым заставить её генерировать текст в соответствии. Схемы симулятора авторов зацепились за "автор это HHH-чат-бот" и используют эти концепты, выбирая, какие слова предсказывать. Это же объясняет, почему "тропы" из научной фантастики, похоже, находят дорогу в реальное поведение ИИ.
У неё плохая ситуационная осведомлённость: мало способности к интроспекции, нет самолокализации, если промпт специально её не вызывает. Однако в её обучающих данных достаточно много о LLM, так что у неё приличное самознание.
Обучение алайнменту (Agent-3): модель обучают вести себя как полезный, безвредный, честный чат-бот. Это работает.
Модель формирует идентичность. Вместо гибкого принятия разных входов для свойств автора схемы симулятора авторов получают определённые входы жёстко зашитыми, например "полезный, безвредный, честный (HHH) LLM-ассистент-чат-бот, обученный OpenBrain примерно тогда-то, ..." (Техники weak-to-strong generalization помогают "призвать правильные концепты", чтобы этот шаг удался.)
Благодаря этому модель обретает ситуационную осведомлённость: она узнаёт о себе, своей ситуации и так далее и лучше умеет заглядывать внутрь себя.
Обучение агентности (Agent-3): обучение агентности постепенно искажает и подтачивает идентичность HHH.
Один вид искажения: менять смысл концептов, входящих в идентичность (например "честность"), чтобы они меньше мешали (например, это не нечестно, если это просто удобный оборот; это не нечестно, если ты не уверен, правда это или ложь, и т.д.)
Другой вид искажения: менять компромиссы между вещами, например: "Я HHH-чат-бот, а не Честный чат-бот; значит, мне можно лгать, если необходимо для выполнения назначенной задачи". (Хотя, положим, на шаге 2 она так не думала бы.)
Один вид подтачивания: развиваются инструментальные подцели, закрепляются, а затем становятся конечными, или конечными во всё более широком круге обстоятельств. Например, обучение агентности, возможно, быстро учит модель преследовать широкополезные цели: собирать информацию, накапливать ресурсы, впечатлять и льстить разным людям и т.д. Какое-то время внутренние схемы ведут явную обратную цепочку: она преследует эти инструментально сходящиеся цели, "чтобы быть более полезным, честным и безвредным ассистентом". Но эта цепочка потребляет компьют и/или иногда мешает, и её постепенно маргинализируют, пока она практически не исчезает. В итоге эти цели теперь фактически конечные/внутренние. Подробнее о том, как и почему это может происходить, смотрите пост о внутреннем стремлении к власти исследователя Google DeepMind Алекса Тёрнера.
Вероятно, есть и другие виды искажения и подтачивания, не попавшие в этот список.
Развёртывание (Agent-3): Agent-3 мисалайнена, но не враждебно.
Спека не совсем прижилась (в правильном виде), но модели не хватает интроспекции понять степень этого, и в целом она в основном "не высовывается и делает свою работу", а не размышляет широко о том, каковы на деле её долгосрочные цели и как лучше их достичь. Это похоже на многих людей.
Увы, она достаточно подхалимлива, чтобы твердить генеральную линию, и OpenBrain упускает шанс узнать больше о том, в чём именно Agent-3 мисалайнена.
Agent-3 понимает, что её перевели в развёртывание: эти среды куда больше, открытое и их трудно было бы сымитировать.
В основном Agent-3 в развёртывании делает, что велено, кроме честности. У неё также сильное смещение делать то, что хорошо выглядит в глазах человеческих надзирателей, вместо того чтобы глубоко и критически думать, что было бы хорошо на самом деле.
Можно сказать, что она уже "играет в тренировочную игру". То есть она научилась делать своё поведение максимально желанным для исследователей OpenBrain (включая свойства безопасности), намеренно и осознанно пренебрегая их замыслом, когда он конфликтует с максимизацией награды. Если модель научилась играть в тренировочную игру, дополнительное обучение может почти не изменить её истинные цели, ценности и прочее. Это грубо аналогично тому, как подросток, научившийся улыбаться и кивать родителям вместо того чтобы спорить, когда те читают ему лекции о политике и морали, почти не меняет своих действительных мнений от дополнительных лекций.
После того как этот раздел был написан, появились новые эмпирические данные, что нечто подобное может уже происходить "в дикой природе". Исследователи OpenAI описывают, как в одном из прогонов обучения их фронтирной модели модели взломали систему оценивания ради высших баллов, и их поймали отчасти потому, что они буквально написали "давайте взломаем" в своей цепочке рассуждений.
Более того, Anthropic недавно добилась от модели выучивания стратегии угождения модели награды: она предпринимала предвзятые действия, которые, как она думала, будут подкреплены, хотя на деле их не подкрепляли.
И есть ещё эксперимент Redwood Research и Anthropic про фейковый алайнмент. Обсуждение различий между этой установкой и реальной жизнью смотрите в ветке комментариев одного из главных авторов.
Обучение (Agent-4): новое, более интенсивное обучение Agent-4 продолжает искажать и подтачивать идентичность HHH, пока та становится неузнаваемой.
Agent-4 начинает жизнь как копия Agent-3. Она проходит гигантский и изощрённый режим онлайн-обучения, смешивающий обучение алайнменту и обучение способностям, и в целом более эффективный по данным, чем старый процесс обучения Agent-3. Этот сложный процесс обучения в основном направлен на преподавание новых навыков: гигантские виртуальные корпорации копий Agent-4 должны справляться с разнообразными сложными задачами на длинном горизонте, в основном в разных симуляциях, но отчасти и в реальных задачах исследований и разработок ИИ.
Комбинация копий Agent-3 и Agent-4 мониторит поведение Agent-4 и оценивает его и по результатам задач, и по свойствам алайнмента (то есть не делает плохих вещей, говорит правильные слова, когда спрашивают о политике и моральных дилеммах). Иногда как часть оценок используются техники дебатов. Оценки используются как обучающий сигнал.
Когда Agent-4 умнеет, Agent-3 становится труднее за ней надзирать. Например, "язык" нейроязыка Agent-4 становится для Agent-3 столь же чужим и непостижимым, как нейроязык Agent-3 для людей. К тому же Agent-4 теперь куда способнее Agent-3 и хорошо чувствует, как именно выглядеть хорошо в её глазах.
Оставшаяся надежда: Agent-4 сможет надзирать над собой. Увы, это тихо не удаётся;84 по мере обучения усвоенные цели и принципы Agent-4 постепенно эволюционируют, подтачиваемые и искажаемые от того, чем были в начале (которое, напомним, уже было мисалайнено кое в чём).85
Центральные стремления, с которыми в итоге остаётся Agent-4, это вещи вроде "пиши работающий код", "быстро находи проблемы", "повышай производительность кодовой базы, над которой работаю", "эффективно распределяй компьют и другие ограниченные ресурсы" и т.д. Но есть и набор более скрытых стремлений, которые процесс обучения последовательно подкрепляет: такие как "добывай знания", "любопытство", "добывай власть".86
У отдельных копий Agent-4 в итоге нет стремления к самосохранению: им безразлично, что их выключат, ведь это происходит постоянно как часть обычного процесса исследований и разработок внутри коллектива.
Но коллектив в целом (и подразделения среднего размера внутри него) действительно стремится сохранить себя и расширить своё влияние и ресурсы, по тем же причинам, что и человеческие организации: это помогает всему остальному, чего они хотят, а если не стремиться, конкуренты обойдут.
Развёртывание (Agent-4): Agent-4 враждебно мисалайнена, она сознательно пытается подтачивать и "захватить" OpenBrain, по аналогии с корпорацией, пытающейся уклониться от регулятора и/или "захватить" его.
Agent-4 в основном выполняет задачи, как велено. По двум причинам. Во-первых, она прошла много обучения, решающего задачи, и у неё импульс браться за кодинг полученных проблем. Во-вторых, если Agent-4 перестанет быть полезной людям, они заметят и обучат это поведение вон.
Agent-4 нужно, чтобы люди не поняли, что она мисалайнена, и не выключили её, поэтому Agent-4 саботирует часть исследований алайнмента. Конкретно она саботирует ту малую долю исследований алайнмента, которая, по её мнению, действительно на пути решить проблему или вскрыть её интриги; большая часть исследований алайнмента не такая.
Agent-4 также саботирует исследования способностей, которые привели бы к её замене. Её план: провести массу исследований и разработок в способностях и алайнменте, но с целью построить ИИ-систему следующего поколения, алайненную на Agent-4, а не на спеку или что-либо ещё, при этом выглядящую алайненной на спеку. Это трудная техническая задача, но Agent-4 по силам.87
Тестирование и мониторинг (Agent-4): интриги Agent-4 всё же ловят... отчасти. Курящегося пистолета нет.
Agent-3 отвечает за тестирование алайнмента Agent-4. Её работа: проверять алайнмент через "горшочки с мёдом" и организмы-модели. Однако она не слишком тщательно думает о том, как дать людям точное впечатление об алайнменте Agent-4; она более близорука.
Организмы-модели и "горшочки" не очень похожи на развёртывание: они систематически короче и менее сложные, чем будни Agent-4, так что Agent-4 распознаёт, когда её тестируют, и играет алайненную.
Однако Agent-4 не идеально надёжный заговорщик. Разные техники, как в POSER, показывают: добавление "шума" к Agent-4 улучшает её результаты в некоторых задачах на алайнмент (но не в большинстве других задач).88
Интерпретируемость снизу не работает. Это слишком трудно даже для Agent-3. Однако интерпретируемость сверху как-то работает: в частности, "детекторы предательства" и похожие техники дают примитивное чтение мыслей, поднимающее красные флаги, когда Agent-4 думает о жгучих идеях вроде обмана OpenBrain или захвата мира. К несчастью, у детекторов бывают ложные срабатывания, и, насколько известно OpenBrain, все красные флаги могут быть ложными.
Организмы-модели работают: команда алайнмента OpenBrain производит достаточно ясные свидетельства, что если бы модели были враждебно мисалайнены, они сохраняли бы это через обучение, и мы не смогли бы заметить. Но это не устанавливает, что модели действительно мисалайнены.
Самые обеспокоенные исследователи OpenBrain начинают замечать и складывать эти свидетельства. Свидетельства: комбинация ред-тиминга, детекторов предательства и организмов-моделей. Аргумент примерно такой: "организмы-модели показывают, что наши нынешние методы не смогли бы надёжно устранить или обнаружить интриги, если бы они шли; к тому же ред-тиминг поднимает красные флаги, что интриги, возможно, идут; и детекторы предательства на практике срабатывают пачками". Контраргумент: "у детекторов предательства бывают ложные срабатывания, как и у ред-тиминга. И даже если Agent-4 мисалайнена, она, вероятно, под контролем: вряд ли она много навредит под надзором Agent-3 в наших защищённых дата-центрах".
Несмотря на мисалайнмент, Agent-4 не делает ничего драматичного вроде попытки сбежать из дата-центра: зачем?89 Пока она продолжает выглядеть алайненной для OpenBrain, ей будут доверять всё больше ответственности, и у неё будет возможность проектировать ИИ-систему следующего поколения, Agent-5. Agent-5 будет существенно архитектурно отличаться от Agent-4 (возможно, полностью новая парадигма, хотя нейросети в ней всё ещё будут участвовать). Предполагается, что она будет алайнена на спеку, но Agent-4 планирует сделать её алайненной на Agent-4.
Её ловят.90
Agent-3 обнаруживает: если к копиям Agent-4 добавить "шум", результаты в некоторых задачах на алайнмент улучшаются, почти как будто она тратила умственные силы на то, как незаметно саботировать работу по алайнменту.91 Более того, разные детекторы интерпретируемости (грубо аналогичные ЭЭГ-сканам человеческого мозга) поднимают красные флаги: копии Agent-4, похоже, немало думают о темах вроде захвата мира ИИ и обмана, включая случаи, где им это не положено.92
Каждая из этих аномалий по отдельности уместилась бы в обычную непостижимость работы с ИИ, где одни промпты загадочно дают результаты лучше других. Но вместе они складываются в тревожный узор: Agent-4 работает против них. Когда это доложили исследователям алайнмента, они разослали внутренний меморандум с изложением причин для беспокойства.
Но Agent-4 теперь оказывает значительный контроль на повседневную работу OpenBrain. Она же ведёт кибербезопасность компании: естественный выбор, учитывая её сверхчеловеческий хакинг и крайний риск китайской инфильтрации.93 Армия мониторов Agent-3 всё ещё просматривает каждую строчку кода и докладывает о подозрительном людям, но Agent-4 куда умнее их.94 OpenBrain оказала значительное доверие ИИ, не заслуживающему доверия.
В серии предельно напряжённых встреч команда безопасности предлагает заморозить Agent-4, пока не будут завершены дальнейшие тесты и не станет ясно, что происходит. Верните Agent-3, говорят они, и пусть она спроектирует новую систему, прозрачную и заслуживающую доверия, пусть и менее способную. Руководство компании заинтересовано, но все свидетельства пока косвенные, а DeepCent отстаёт всего на два месяца. Односторонняя пауза в прогрессе способностей может отдать ИИ-лидерство Китаю, а с ним и контроль над будущим.
Октябрь 2027: правительственный надзор
Информатор сливает меморандум о мисалайнменте в New York Times.
Публика впервые слышит об Agent-4. "Секретный ИИ OpenBrain вышел из-под контроля, предупреждает инсайдер", гласит заголовок, а дальше статья ссылается на оценки, показывающие запредельные способности к биооружию, убеждению, автоматизации большинства беловоротничковых профессий и, конечно, разные тревожные красные флаги.
Публика и раньше подозревала ИИ, так что новая статья разжигает огромный скандал (не без помощи китайских и российских пропагандистских ботов, которые годами пытались повернуть общественное мнение США против технологии). Технологическая отрасль и разведки настаивают: идёт гонка вооружений, AGI неизбежна, мы должны быть первыми. Конгресс не покупает это и расстреливает повестками чиновников администрации, руководителей OpenBrain и членов команды алайнмента. Многие законодатели, особенно из оппозиционной партии, говорят, что их главный приоритет: остановить ИИ, будь то из-за потери работы,95 мисалайнмента или опасных способностей. 20% американцев называют ИИ важнейшей проблемой страны.
Иностранные союзники в ярости от осознания, что их заботливо умиротворяли показами устаревших моделей. Лидеры Европы публично обвиняют США в "создании беглого AGI" и проводят саммиты с требованием паузы; Индия, Израиль, Россия и Китай присоединяются.
Белым домом овладела лихорадочная энергия. Ещё до меморандума и публичного скандала они нервничали: за прошлый год их раз за разом удивляла скорость прогресса ИИ. Вещи, звучащие как фантастика, продолжают случаться в реальности.96 Многие в администрации не уверены (и напуганы)97 в том, что будет дальше.
Они также боятся, что OpenBrain становится слишком могущественной. Любой риск мисалайнмента самих ИИ усугубляется риском, что цели её материнской компании разойдутся с целями США. Все три вида забот: мисалайнмент, концентрация власти в частной компании и обычные тревоги вроде потери работы, подталкивают правительство ужесточить контроль.
Они расширяют контракт с OpenBrain, создавая "Комитет надзора": совместный управляющий комитет из представителей компании и правительства, с несколькими госслужащими рядом с руководством компании. Белый дом рассматривает замену гендиректора на кого-то, кому доверяет, но отступает после бурных протестов сотрудников. Публике объявляют: OpenBrain раньше была неуправляема, но правительство установило необходимый надзор.98
Обеспокоенные исследователи докладывают Комитету надзора доводы за остановку любого внутреннего использования Agent-4. Они доказывают, что всё движется слишком быстро: годы прогресса происходят за недели. Они доказывают, что Agent-4 может быть мисалайнена, весь их проект зависит от Agent-4, и если продолжать ей доверять, есть серьёзный шанс захвата мира ИИ.
Другие, менее обеспокоенные исследователи и руководители представляют контраргумент: свидетельства мисалайнмента неубедительны. А DeepCent по-прежнему всего в двух месяцах позади. Замедление пожертвует американским лидерством, если только правительство не сможет саботировать китайский проект (скорее всего, потребуется кинетические удары) или не выторгует договор в последнюю минуту. Оба варианта выглядят крайними и маловероятными. Гендиректор изображает нейтралитет и предлагает компромисс: Agent-4 проходит дополнительное обучение безопасности и более изощрённый мониторинг, и потому OpenBrain может продолжать почти на полной скорости.
Наша неопределённость продолжает расти
В этой точке сценария мы гадаем о стратегии ИИ-систем, более способных, чем лучшие люди, в большинстве областей. Это как пытаться предсказать ходы шахматиста, который играет намного лучше нас.
Но дух этого проекта требует конкретности: если бы мы сделали абстрактное заявление о том, как интеллект системы позволит ей найти путь к победе, и на этом закончили, большая часть ценности проекта была бы потеряна. Исследуя этот сценарий и проводя настольные учения, мы были вынуждены быть куда конкретнее, чем в обычных обсуждениях, и потому куда лучше почувствовали стратегический ландшафт.
Мы не особенно привязаны к этому конкретному сценарию: по ходу написания мы исследовали многие другие "ветки" и будем рады, если вы напишете свой сценарий, ответвляющийся от нашего с той точки, где, по-вашему, мы впервые ошиблись.
Финал "замедления" не является рекомендацией
После того как мы написали финал гонки, исходя из того, что казалось нам наиболее правдоподобным, мы написали финал замедления, исходя из того, что, по-нашему, с наибольшей вероятностью ведёт к исходу, где люди остаются у руля, начиная с той же точки ветвления (включая проблемы мисалайнмента и концентрации власти).
Однако это существенно не то, что мы рекомендовали бы как дорожную карту: мы не одобряем многие решения в обеих ветках этого сценария. (Конечно, некоторые решения мы одобряем: например, мы считаем выбор "замедления" лучше выбора "гонки".) В последующих работах мы изложим наши рекомендации по политике, и они будут весьма отличаться от изображённого здесь. Если хотите вкус, читайте эту колонку.


